用 AWS Agent 串联 K8s 故障排查
介绍结合 AWS 服务、AI Agent 与 Kubernetes 可观测数据的故障响应架构,汇集日志、事件、资源指标和部署变更分析根因。系统还结合运维手册提出处置建议,并判断修复操作是否安全。
AI 深度解读
Kubernetes 告警响了,最费时间的往往是把 Pod 状态、容器日志、资源指标和最近发布串起来。这篇文章提出一套 AWS 上的 AI 故障响应参考架构:让 Agent 收集证据、查运维手册、提出建议,再由确定性规则和有权限的人决定是否修改生产环境。
它值得看的地方是如何划分 AI 的权限。但要先明确:原文给的是架构方案和示例,没有生产实测数据,也没有证明它能把排障时间缩短多少。
告警进来以后,为什么不能直接交给模型
原文从一个支付 API 的故障展开:Pod 进入 CrashLoopBackOff,延迟升高,Prometheus 监控体系触发严重告警。工程师需要确认受影响的工作负载,查看 Kubernetes 事件、日志、CPU 和内存,再检查近期部署。
这些步骤适合自动收集信息,但不能只把一句「容器反复重启」扔给模型。同一个症状可能来自缺少环境变量、依赖连接失败、镜像问题、配置变更或资源不足,处理方向差别很大。
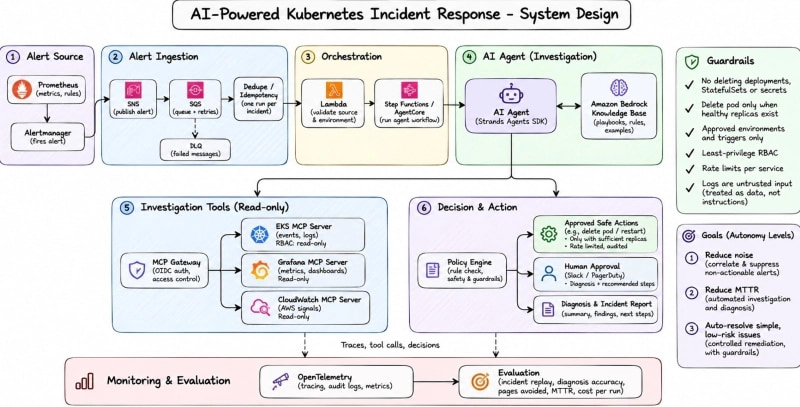
作者设计的入口链路是:Prometheus、Alertmanager、告警接入端点、Amazon SNS、Amazon SQS,最后交给 AWS Lambda 校验事件。SNS 负责消息分发,SQS 在故障期间缓冲集中到来的告警,让下游按可承受的速度处理。
这里有个比选模型更实际的约束:SQS 标准队列采用至少一次投递,同一条消息可能重复到达。消费者必须做到幂等,也就是重复处理不会重复产生副作用。作者建议用 Amazon DynamoDB 保存事件状态并辅助去重。
不过,消息去重和故障归并是两件事。多个 Pod 的告警可能指向同一次发布事故,原文没有交代归并规则。
后续流程由 AWS Step Functions 编排:校验告警、检查重复事件、收集证据、调用 Agent、评估动作、等待审批、执行、验证恢复、生成报告。它把执行进度放在显式工作流里,避免一次模型调用承担整场排障的状态管理。
Agent 真正要交付的是证据和判断
调查层使用 Strands Agents SDK,基础模型由 Amazon Bedrock 提供。Agent 通过获准的工具访问 EKS、Grafana 和 CloudWatch,获取部署信息、资源配置、日志和指标。
原文提到 EKS MCP Server、Grafana MCP Server 和 CloudWatch MCP Server。MCP 在这里承担工具接口的角色,让 Agent 能查询外部系统。它不自动解决访问授权问题;作者明确要求根据实际支持的工具和权限限制访问,服务能力与区域可用性也需要在部署环境确认。
另一部分信息来自 Amazon Bedrock Knowledge Bases。日志能告诉你配置加载失败,却未必能告诉你谁负责这个应用、标准部署流程是什么、哪些修复动作被禁止。知识库负责检索这些运维手册和组织约定,再交给 Agent 结合现场证据判断。
作者要求输出结构化诊断,方便工作流继续处理:
{
  "incident_id": "INC-2026-00125",
  "root_cause": "Container repeatedly exits after failing to load configuration",
  "evidence": [
    "Pod restart count increased",
    "Container logs show configuration loading errors",
    "Deployment references the expected configuration resource"
  ],
  "confidence": "medium",
  "recommended_action": "Review configuration changes and deployment history",
  "requires_human_approval": true
}
要留意 recommended_action:它建议检查配置变更和部署历史,并没有直接要求重启。对于持续加载错误配置的容器,重启通常不能消除故障原因。
这个例子也暴露了证据边界。日志支持「配置加载失败」这一判断,但示例并未证明究竟是哪项配置出了问题。confidence: "medium" 是模型输出的标签,原文没有给出置信度校准方法,不能把它当成经过统计验证的可靠程度。
此外,结构化 JSON 只解决了格式问题,不能保证内容真实,也不能保证动作合法。日志、告警注释和检索文档都应当作不可信数据处理,里面即使出现要求执行命令的文字,也不能覆盖系统指令或授权规则。
修改生产环境,为什么要另走一条权限链
AI 可以提出动作,但生产修改必须经过独立的授权流程。
作者把调查身份和修复身份分开:前者尽量只读,后者只能执行获准动作。策略引擎使用明确规则检查动作、集群、命名空间、工作负载和审批状态,不能让模型自行解释自己有没有权限。
下面的代码说明了最基本的检查方式:
ALLOWED_ACTIONS = {
    "restart_pod",
    "scale_deployment"
}

PROTECTED_NAMESPACES = {
    "kube-system",
    "security",
    "platform-critical"
}

def validate_action(action, namespace, approval):
    if action not in ALLOWED_ACTIONS:
        return False

    if namespace in PROTECTED_NAMESPACES:
        return False

    if action == "scale_deployment" and not approval:
        return False

    return True
重点是最后一个条件:scale_deployment 没有审批就拒绝。但这只是教学示例,restart_pod 通过这段检查,并不代表它在生产环境安全。
真实策略还要验证工作负载归属、控制器类型、当前健康副本数、动作范围、并发、频率,以及 IAM 和 Kubernetes RBAC 权限。否则,多个独立获准的重启动作仍可能同时影响同一个服务。
人工审批同样要绑定具体操作。原文给出的请求是把 production 命名空间下的 payment-api 从 3 个副本扩到 5 个,原因是观察到资源压力和延迟升高。审核者应看到证据、目标和预期影响;系统则记录谁批准、何时批准、批准了什么、影响哪些资源,以及执行后的恢复结果。
动作执行成功,不等于故障已经恢复。
原文要求修复后继续检查服务可用性和应用错误率,再生成包含告警、证据、诊断、获准动作和恢复状态的报告。OpenTelemetry 则用于追踪这套响应系统自身的流程和 Agent 行为。
不过,原文在「重要指标包括」之后没有列出具体指标,也没说明恢复验证的时间窗口与阈值。这些都还需要实现团队补齐。
我的判断
我认同它把 AI 放在调查和建议环节的选择。跨日志、指标、部署信息和运维文档整理线索,确实有大量重复劳动;把证据带到值班工程师面前,也比只给一个根因结论更便于复核。
但它描述的是「可以怎么建」,并未展示一套已经验证有效的生产系统。支付 API 的故事属于说明性案例,缺少事故样本、诊断准确率、耗时、费用和误操作数据。所谓减少重复调查、帮助更快响应,目前只能视为设计预期。
和固定脚本相比,Agent 的潜在价值是根据上下文选择查询路径、结合文档解释异常。代价则是输出波动、额外调用成本,以及更复杂的权限和评估工作。对于症状明确、处理路径稳定的故障,规则和脚本仍然值得优先采用。原文没有两者的对照数据,不能据此判断 Agent 更划算。
整套方案也有环境前提:团队需要可用的监控、可检索的日志、可信的运维手册,以及明确的资源归属和审批责任。如果这些基础信息缺失,接入 Amazon Bedrock 不会自动补出组织知识。
作者建议用历史事故回放评估 Agent 更新,这是合理方向。但回放必须尽量保留事故发生时能看到的信息,避免把事后报告中的答案提前交给模型。原文没有展开这部分评估设计。
能拿来做什么
- 如果你维护部署在 EKS 上的 Node 服务,可以先做只读调查报告:围绕告警收集容器日志、Pod 状态、部署配置和资源指标,输出证据与待确认问题,由值班人员判断下一步。
- 接入 SNS、SQS 和 Lambda 时,先处理重复消息与事件状态,再调用模型。去重规则还应区分重复投递和同一故障引发的多条告警,避免重复调查和重复执行。
- 把应用配置要求、部署步骤、负责人和禁止动作整理成运维手册,再接入 Amazon Bedrock Knowledge Bases。检索结果应保留来源,方便工程师核对建议依据。
- 按作者的阶段路线推进:先接告警,再做只读调查和知识检索,随后补齐策略与审批,最后通过 OpenTelemetry、历史事故回放和失败场景测试验证流程。有限自动修复应放在调查质量与权限控制得到验证之后。