代码语义搜索落地:存储、检索与智能体
JetBrains 分享构建并上线代码搜索 RAG 系统 Air Context 的经验。本篇聚焦存储、搜索和智能体工具,承接前篇的代码分块、解析与向量化流程。
AI 深度解读
代码切成片段、算好向量,离能用的语义搜索还很远。JetBrains 团队用过去六个月建设 Air Context 的经历说明:生产级代码 RAG 的难点,是让索引跟得上 Git、守得住权限,还能把真正有用的代码交给 Agent。
这篇是系列第二篇,重点在存储、检索和工具接入。值得程序员读的不是某个向量数据库选型,而是一条完整思路:先控制搜索范围,再提高候选质量,最后控制送入模型的上下文。不过,其中不少效果仍是工程经验,尚缺对照数据。
搜得相似之前,先保证搜得对范围
真实代码库可能产生数百万条向量,同时存在几十个分支。Agent 又希望在毫秒级拿到结果,而且只能看到指定仓库、路径和权限范围内的代码。Embedding 模型只负责把代码表示成向量,解决不了这些约束。
逐条比较百万向量太慢,因此需要近似最近邻搜索(ANN),例如 HNSW、IVF。它们跳过大量比较,用部分召回率换速度;召回率指真正相关的结果有多少被找回来。
作者采用 ANN 初筛,再对缩小后的候选集做精确比较。这样能兼顾规模与候选排序,但精确比较不能找回初筛已经遗漏的代码,原文也没有给出这套组合的召回率和延迟数据。
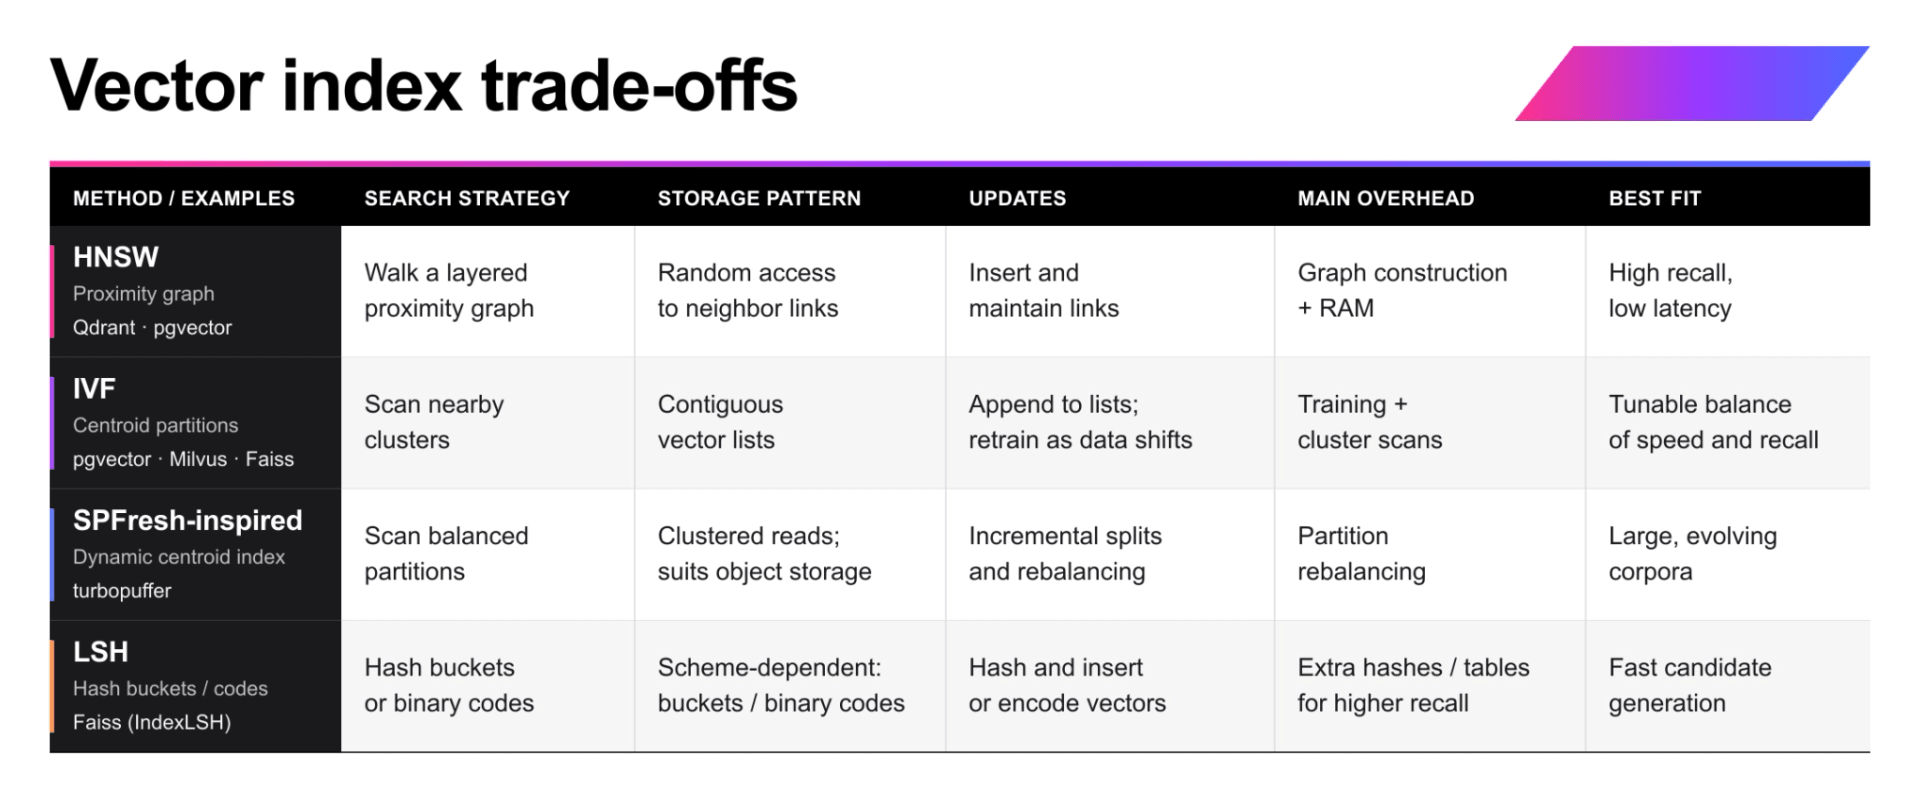
更棘手的是过滤。HNSW 依赖图中节点之间的连接寻找邻居,如果限制只能经过符合权限或路径条件的节点,图可能断开,搜索也可能漏掉有效结果。
原文比较了三条路线:
- 先过滤,再搜索。 过滤后只剩一个小仓库或狭窄子目录时,可以直接做精确搜索。作者提到相对过滤集合的 100% 召回,应理解为穷举该集合能保留其中的精确近邻,不能理解成业务相关代码一定全部找齐。剩余集合很大时,成本仍然高。
- 让索引原生支持元数据过滤。作者以 Qdrant、turbopuffer 为例,认为这更适合带访问控制列表(ACL)的生产系统。关键是过滤参与检索过程;原文没有展开两者的具体实现。
- 先做 ANN,再过滤结果。取出的 top-K 可能大半不符合条件,最终剩下的结果又少又差。pgvector 的 iterative-scan 模式可以继续获取候选,直到留下足够结果,但会增加延迟,也让耗时更难预测。
这里应该记住的边界是:相似度允许近似,权限必须确定执行。不能因为向量距离很近,就把用户无权访问的代码交给 Agent。
索引要跟着 Git 变,不能每次从头算
每次提交都重建整个仓库索引,很快就会撞上计算和存储成本。多个分支共享大量代码,也不应该为相同片段重复保存向量。
作者提出以 Merkle tree 表示仓库快照,结构对应目录树。每个子树的哈希反映其内容,比较两个版本时,可以从上往下跳过完全没变的部分。未变子树直接关联到新快照,变更区域里的 chunk 再按内容哈希去重,只为实际变化的代码生成新索引。
这相当于把 Git 的增量思路延伸到检索系统里。
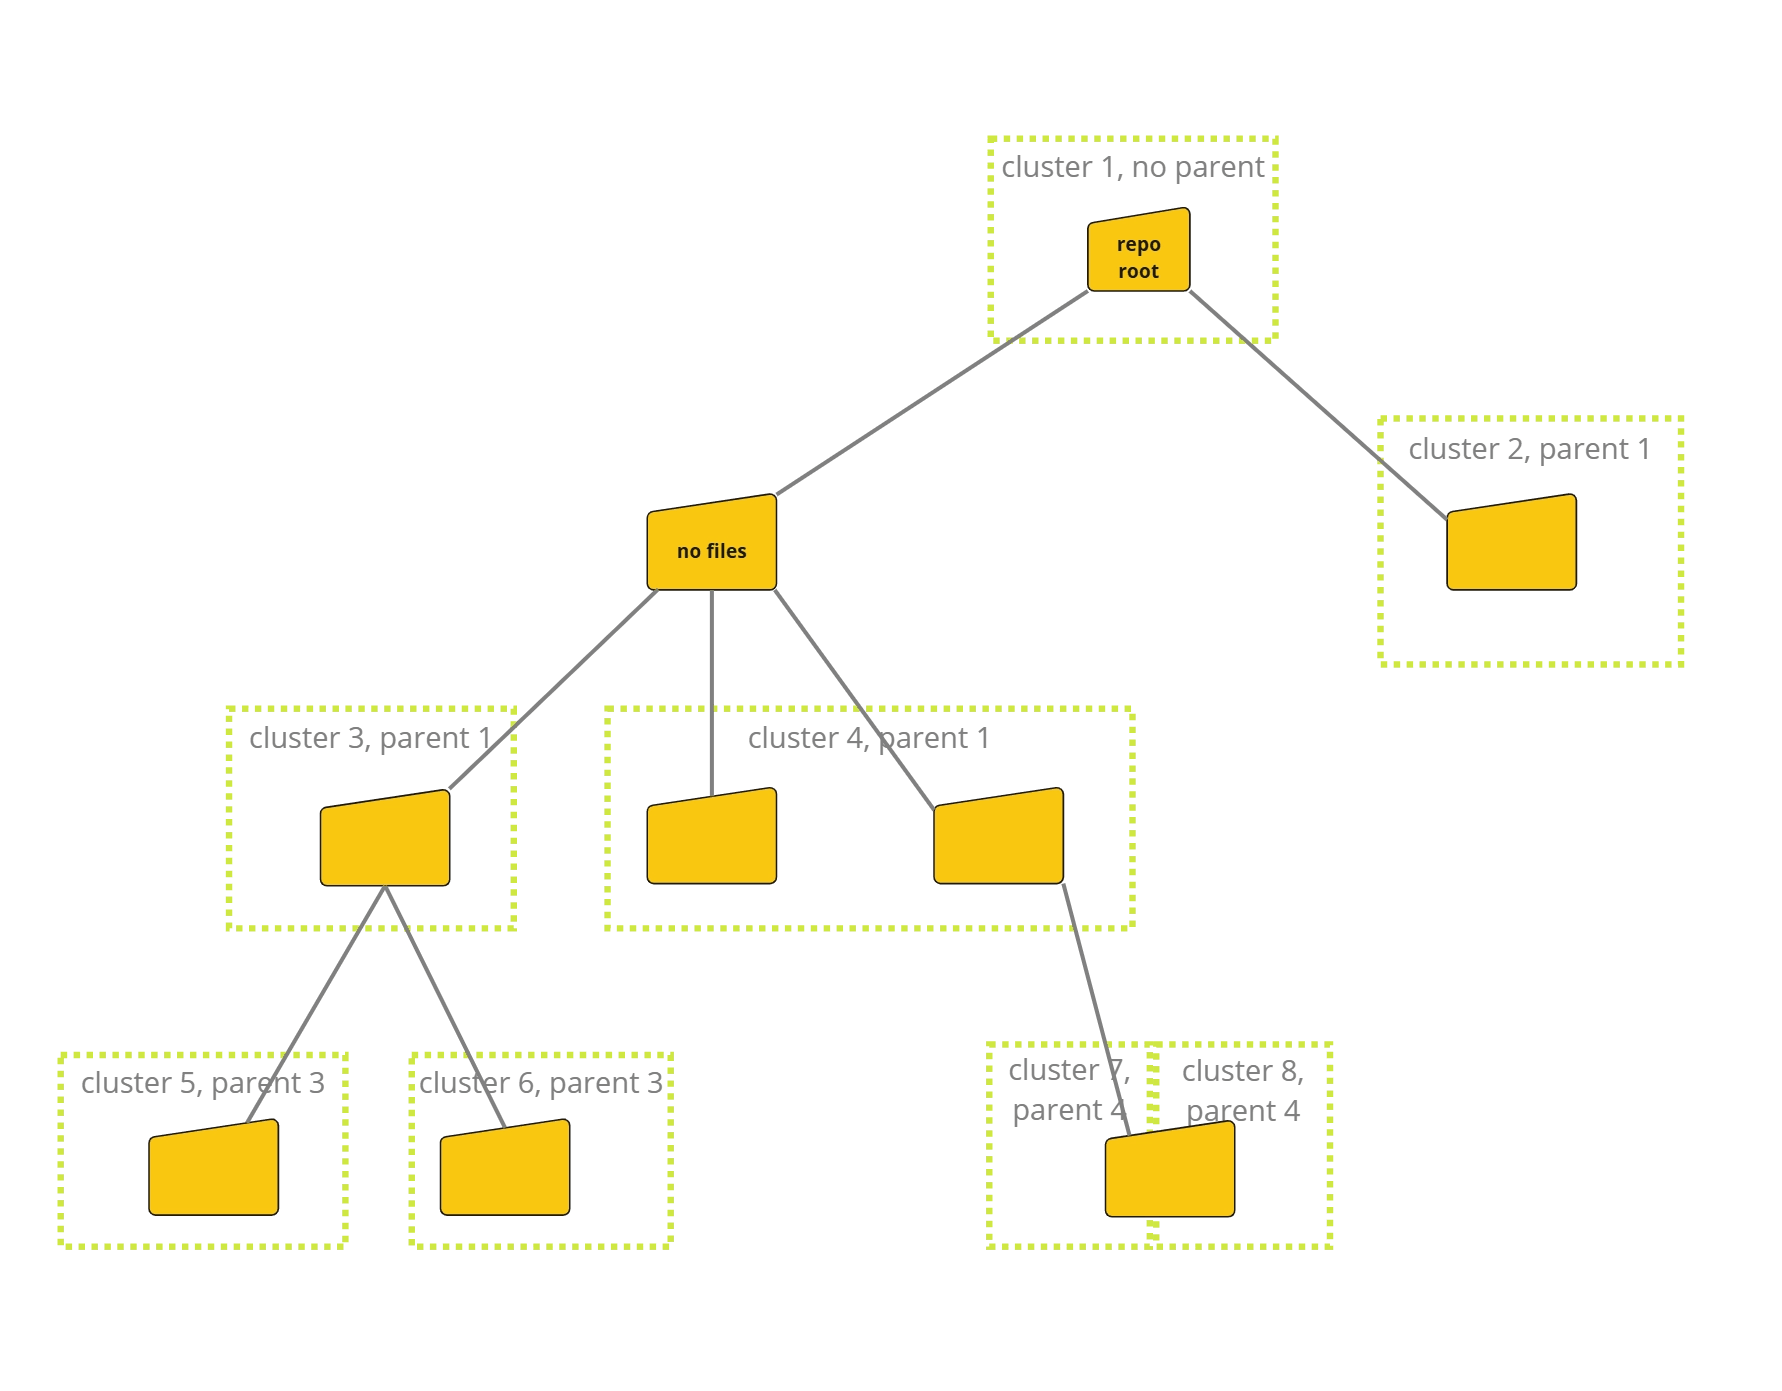
但少算向量还不够。作者明确说,HNSW 索引构建是数据库流水线的主要 CPU 瓶颈之一。他们把向量写入和建索引拆开:先完整存入仓库快照,再异步构建 HNSW;每个分片最多同时执行一次索引构建,快照要等索引就绪后才能搜索。
更新、删除则拆成小事务,限制锁的占用范围和并发。规模继续增长时,再通过分片横向扩展:每个分片有自己的主实例和只读副本,查询由跨地域部署的只读副本承接;每个客户固定归属一个分片,由应用根据客户标识路由。
这套安排优先保证数据库稳定,也引入了一个明确取舍:代码已经写入存储,不代表它立即可搜索。原文没有给出这段等待的时延。
本地未推送的代码还有另一套处理方式。Air Context 使用 USearch 在设备上保存和检索向量,元数据单独存储,但沿用服务端的快照、cluster、chunk 模型,因此同样可以复用未变部分、去重相同片段。
查询先访问远端索引,再访问本地索引,最后用 reranker 合并两边的候选。这样,共享分支由远端承担,开发者手头的新代码由本地补齐。原文称代码推送后可以平滑过渡到远端索引,但没有展开删除、覆盖和跨版本冲突的处理细节。
找到候选以后,还要决定给 Agent 看多少
最近邻搜索返回的是候选,不是可以直接使用的答案。候选里可能有重复片段、同一函数的多块代码,也可能只是因为出现了相同的罕见词而得分较高。
因此,作者还会去重、按文件归并片段、控制结果数量,并进行重排(reranking)。向量初筛分别编码查询和代码,再比较距离;reranker 则把查询与候选放在一起判断相关性。面对几十个候选,更细致的判断才有机会承担得起。
这里也要分清两件事:精确向量比较仍然在衡量向量距离,reranker 则重新判断内容是否匹配任务。
团队还试过 ICTIR ’25 提出的 JointRank:把候选分成彼此重叠的组,由语言模型并行排序,再合并局部顺序。作者说,一些检索配置提高了质量,但资源消耗和搜索耗时也明显增加;没有给出足以比较收益的数据。
当单次检索不够时,他们还探索了专门的代码检索 Agent。它可以自行选择搜索、读文件、继续查找或结束,并通过步数上限控制预算。
这种检索器可以实现为 sub-agent,使用独立上下文,只把结论交回主 Agent。原文以 Claude Code 的自定义 sub-agent 为例,还提出使用更便宜或更快的模型、限制为只读工具,以及并行处理独立问题。这些是可采用的设计方式,文章并未逐项证明它们带来了多少收益。
最后一个细节很实用:返回结果的详略随相关性变化。高分候选附完整代码片段、行号和元数据;低分候选只给文件名或少量片段。目的是减少后续读文件调用,同时避免把整个候选列表都塞进上下文。
我的判断
我认同这篇文章把重点放在存储约束和结果交付上。对代码搜索来说,仓库版本、权限和本地改动都直接影响答案是否可用,仅换一个 embedding 模型无法补齐这些环节。
但一般团队不必照搬全部架构。如果目标只是搜索一个规模有限的仓库,原文提到的过滤后精确搜索就可能够用。分片、跨地域副本、本地与远端级联,都有各自要解决的规模问题,也有额外维护成本。
对前端和 Node 项目,还应把语义搜索与常用的文本搜索、符号导航放在一起判断。已知函数名、报错文本时,直接检索往往路径更短;只知道行为描述、不了解实现位置时,语义检索才更有发挥空间。本文没有提供这些路线的对照实验,不能据此宣布 RAG 普遍占优。
作者预告,后续端到端实验里,使用 Air Context 的 Agent 完成任务所需轮次最多减少 70%。这是上限表述,本篇没有交代任务分布、模型配置、成本和成功率,不能直接换算成开发效率提升 70%。
文章称 Air Context 已进入 public preview,并包含在 JetBrains AI 订阅中;这属于原文发布时的产品状态。就技术结论而言,我更愿意把它当作一份生产系统设计记录,而不是已经完成效果论证的选型报告。
能拿来做什么
- 给前端或 Node 仓库接语义检索前,先明确仓库、分支、目录和权限如何约束结果,再决定向量存储方案。只有单个小范围时,可以先验证精确搜索是否已经够用。
- 让索引跟随提交增量更新,并按代码片段内容哈希去重。同时记录快照从写入到可搜索的耗时,避免 Agent 查到旧代码却无法识别。
- 优先整理检索返回值:去重、合并同文件片段,为高相关结果提供代码和行号,为低相关结果保留位置线索,再观察是否减少了后续读文件调用。
- 如果要增加检索 sub-agent,就给它独立上下文、只读工具和步数上限,并用自己的任务比较完成率、轮次、总耗时和 token 成本,判断多一层调度是否划算。