用 Python 搭建有交接上限的智能体调度器
教程用普通 Python 构建路由器、专业智能体与限制交接次数的调度循环,模型调用留作可替换接口。示例以账单咨询和产品故障为场景,说明何时需要拆分知识、工具与权限。
AI 深度解读
多 Agent 系统的价值,不在于让几个角色轮流说话,而在于把请求交给合适的人、传递必要上下文,并在处理失败时及时停下。作者用一个纯 Python 客服示例,把这件事拆成路由器、专职 Agent 和受限循环。
这套实现适合拿来理解调度逻辑,但距离生产系统还有缺口。对程序员最有用的,是看清角色分工、交接协议和退出条件怎样配合,以及哪些边界不能只靠提示词保证。
什么时候才值得拆出第二个 Agent
作者的起点很克制:多数场景一开始不需要多个 Agent。每增加一个角色,都会增加延迟、成本和故障点。只有两类工作需要不同指令、不同工具或不同权限时,才值得拆开。
示例选择了账单咨询和产品故障。billing 负责账单,回答限制在三句话以内;tech 负责逐步排查产品问题。它们需要的知识和访问权限不同,放在同一段提示词里容易互相干扰。
不过,「混在一起会让两类回答都变差」是作者的经验判断,原文没有提供对照实验。对于任务简单、工具相同的客服,一个 Agent 加明确规则也可能足够。
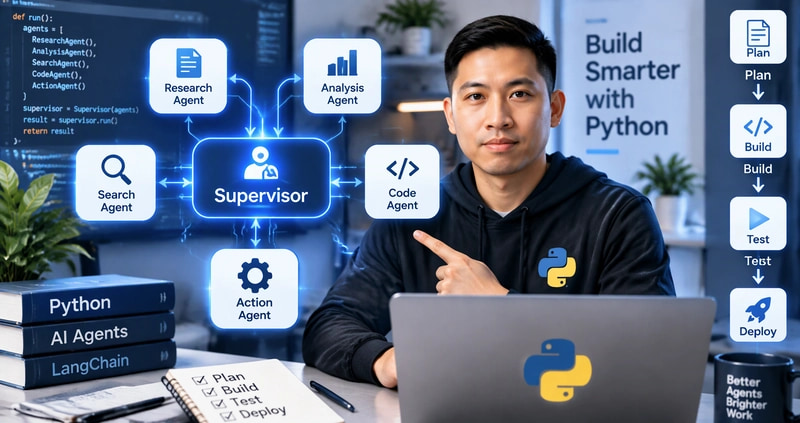
这里的监督器(supervisor)可以理解成一个调度程序:决定谁来处理,检查是否需要转交,最后给出回答或升级处理。它不必再是一个拥有复杂人格的 Agent。
路由结果必须先校验,才能参与调度
模型调用统一经过 call_model(system: str, messages: list[dict]) -> str。原文只放了抛出 NotImplementedError 的占位函数,需要自行接入模型服务,并保证返回纯文本。
专职角色用 @dataclass 定义的 Specialist 保存,注册在 SPECIALISTS 中。路由提示词 ROUTER_PROMPT 要求只返回 JSON,包含 agent 和 reason,其中 agent 只能是 billing、tech 或 none。
下面这段解决的是:模型返回格式出错时,调度程序如何退出。
def route(message: str) -> dict:
    raw = call_model(ROUTER_PROMPT, [{"role": "user", "content": message}])
    try:
        decision = json.loads(raw)
    except json.JSONDecodeError:
        return {"agent": "none", "reason": "router output was not valid JSON"}
    if not isinstance(decision, dict) or decision.get("agent") not in SPECIALISTS:
        return {"agent": "none", "reason": "no matching specialist"}
    return decision
要看的是 decision.get("agent") not in SPECIALISTS:即使 JSON 能解析,也不能让一个不存在的角色进入后续流程。模型在 JSON 前后加解释文字,同样会触发降级。
这份校验只覆盖了部分边界。它没有检查 reason 的类型,也没有捕获模型请求超时等异常。返回 none 的效果是停止调度,具体如何通知人工,代码没有实现。
两轮上限限制了什么,交接时又保留了什么
专职 Agent 发现任务不属于自己时,需要以固定前缀 HANDOFF: 返回说明。监督器读取这个前缀,再把请求交给路由器重新判断。
下面的循环把交接协议、上下文和退出条件放在一起:
def handle(message: str, max_hops: int = 2) -> dict:
    log = []
    context = message
    for hop in range(max_hops):
        decision = route(context)
        log.append({"hop": hop, "route": decision})
        if decision["agent"] == "none":
            break
        specialist = SPECIALISTS[decision["agent"]]
        reply = call_model(specialist.system, [{"role": "user", "content": context}])
        log.append({"hop": hop, "agent": specialist.name, "reply": reply})
        if not reply.startswith("HANDOFF:"):
            return {"status": "answered", "reply": reply, "log": log}
        note = reply.removeprefix("HANDOFF:").strip()
        context = f"{message}\n\nNote from the previous specialist: {note}"
    return {"status": "escalated", "log": log}
要看 context = f"{message}..." 这一行:下一位 Agent 收到的是原始问题和上一位的交接说明,不会只能依赖摘要猜测用户需求。不过,多次交接时,它也只保留最近一次说明,并未累计全部历史。
默认 max_hops=2,允许首次分配后再尝试一次。作者认为继续转交通常说明路由出了问题,应该让人工介入;提高上限需要日志证据。
这里还要按代码算清成本:一轮成功路由包含一次路由调用和一次专职 Agent 调用。 因此,两轮最多会触发四次模型调用,而不是两次。
函数返回完整 log,记录路由决定和专职回复,便于排查用户为什么被来回转交。但 escalated 只是一个返回状态,接工单、通知人工仍需补齐。
我的判断
我认同它先验证调度骨架的做法。原文用 fake_model 替换 call_model,按 invoice 和 crash 分流,再用普通 assert 检查两类问题返回 answered、天气问题返回 escalated,不需要 API key。
但这只能证明几个分支能跑通。替身始终返回普通答案,没有覆盖真正的 HANDOFF: 交接,也没有验证错误 JSON、未知角色和循环耗尽。
作者建议再收集 20 或 30 条真实消息,标好预期角色,在修改提示词前后各跑一次。这是实用的回归起点,却不足以证明线上效果;原文没有给出准确率、延迟、成本或单 Agent 对照数据。
相比让单个 Agent 选择工具,这种方案适合角色职责确实不同的情况。但拆出角色不等于实现权限隔离。作者也把按角色设置工具允许列表列为后续第一项,其次是路由置信度低时转人工,最后为每条日志添加 trace ID。置信度阈值如何设定、分数是否可信,原文没有展开。
能拿来做什么
- 给现有 AI 客服列一张职责表,比较指令、工具和权限;只有差异明确时,再拆出账单与技术支持等角色。
- 在 Python 或 Node 调度层保留原始问题、交接说明和次数上限,同时明确
escalated要进入哪个实际处理流程。 - 按原文收集 20 或 30 条真实消息做路由回归,并补测格式错误、未知角色、真实交接和次数耗尽,区分程序分支正确与模型判断正确。
- 接入业务工具前,在执行层落实每个角色的工具允许列表,再补齐 trace ID,方便追踪一次请求经过了哪些角色。