用 hikyaku 搭建跨厂商模型网关
文章演示将 Go 编写的开源消息中继 hikyaku 用作 LLM 网关,通过统一端点和 YAML 配置集中管理模型选择。方案包含按请求路由、重试及跨供应商故障切换,以减少各服务中的模型配置耦合。
AI 深度解读
把模型 SDK、API Key 和具体模型名散落在各个服务里,接入时省事,换模型和处理故障时就麻烦了。作者用 Go 编写的开源消息中继 hikyaku 搭了一个 LLM 网关:业务只请求 fast、smart 或 auto,具体调用谁、失败后找谁,都放进配置。
这篇最有用的地方,是把自动选模型、跨供应商降级和验证串成了一条可操作的链路。但演示跑通,离省钱又可靠的生产服务,还有几处需要补证据。
一个入口,怎样接住三家模型
hikyaku 原来用于消息转发。作者把聊天请求当作消息,把模型当作目的地,再通过路由决定发往哪里。
入口是 type: openai 的 source,监听 :8080,提供 /v1/models 和 /v1/chat/completions。出口是三个 type: model 的 destination,通过 Genkit Go 调用供应商,加载 systemone、googlegenai、anthropic、openai 插件。
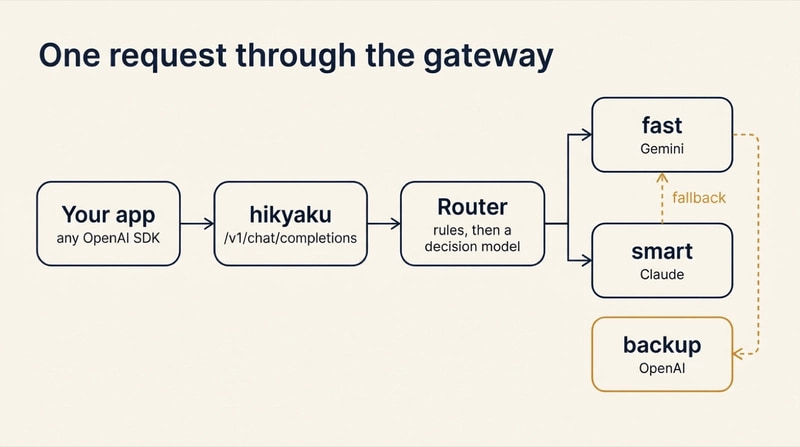
配置中的映射是:fast 对应 googleai/gemini-3.8-flash,smart 对应 anthropic/claude-sonnet-5-5,backup 对应 openai/gpt-5.4-mini。降级链为 smart → fast → backup,每一步跨越供应商。
这些具体模型名来自原文示例,原文没有进一步说明其可用范围。
客户端公开的名称只有 auto、fast、smart。已有 OpenAI SDK 通过修改 base_url 和网关密钥接入,响应的 model 字段则显示实际服务的模型。具体供应商因此可以在 YAML 中替换。
供应商密钥留在网关,通过 GEMINI_API_KEY、ANTHROPIC_API_KEY、OPENAI_API_KEY 引用;客户端只发送 PROXY_KEY。原文说明,调用方的 Authorization 不会复制进消息,缺少或使用错误密钥会得到 OpenAI 错误格式的 401。
运行要求是 hikyaku 1.5.0 或更新版本,安装命令为 brew install xavidop/tap/hikyaku,或 go install github.com/xavidop/hikyaku/cmd/hikyaku@latest。启动前先执行 hikyaku validate 和 hikyaku doctor,后者解析密钥并检查模型能否响应;hikyaku graph 可查看路由与降级关系,最后用 hikyaku run 启动。
自动选模型,为什么先走规则
作者没有让每条请求都经过 AI 分类。明确请求 fast 或 smart 时,规则直接分发;只有 model: auto 才调用决策模型 typesafe/jev-1.13.0,需要额外配置 TYPESAFE_API_KEY。
这个决策模型由 TypeSafe 提供,经 Genkit 的 System One 插件调用。按原文描述,它回答预设候选中的选择题,并给出经过校准的概率。这里候选只有两个:问候、查询、改写等简单任务交给 fast,多步推理、数学、代码和分析交给 smart。
知道该用哪个档位时,直接指定,才能省下分类本身的开销。
配置使用 min_confidence: 0.6,信心不足时由 on_low_confidence: [smart] 转给强模型。未知名称如 gpt-9 则跳过 AI 路由,进入静态兜底 fast。这个默认行为需要调用方知情,否则拼错模型名也可能收到正常答案。
想先看选择结果,可以用原文的命令检查两份请求:
hikyaku route --dry-run --source api --data @easy.json
hikyaku route --dry-run --source api --data @hard.json
关键是 --dry-run:它不调用聊天模型,但仍会执行路由决策,不能理解成完全没有模型调用。输出同时展示概率和完整降级计划。
作者又用问候、查询、改写、代码、数学、分析六个标注案例执行 hikyaku ai test --route chat --cases cases.yaml。结果为 100.0% (6/6),precision、recall 均为 1.00,校准误差 ECE 0.000;决策延迟为 p50 147ms、p95 307ms、最大 307ms。
这是演示数据。它证明测试链路能工作,没有证明真实业务也能保持这个准确率。--min-accuracy 0.9 可以让低于门槛的测试以退出码 1 结束,适合放进 CI;固定 jev-1.13.0 也有必要,因为阈值按版本调节。
故障能兜住,但已经输出的半句话接不住
默认投递配置是 timeout: 60s,以及 retry: { attempts: 2, backoff: 500ms }。这里 attempts: 2 表示总共两次尝试,原文的故障日志也对应两次失败后降级。
作者用故障注入让 smart 全部失败:
hikyaku chaos --destination smart --fail 100%
要看的是 --destination smart:故障只注入这个目的地。客户端继续请求 smart,最后由 Gemini 返回答案,耗时 4.3 秒。hikyaku_delivery_attempts_total 记录了 smart 两次失败、fast 一次成功,hikyaku_fallback_total 记录了一次切换。
这证明了跨供应商降级能跑通,也说明用户仍会承担重试等待。原文称熔断器会在足够多的失败后暂时跳过故障目的地,但没有给出触发阈值和恢复窗口。
流式响应还有一条明确边界。设置 stream: true 后,答案通过服务器发送事件(SSE)返回;stream_options.include_usage: true 会增加携带用量的末尾分块,并以 [DONE] 结束。
第一个分块发出前,失败可以重试或降级。发出之后,失败会用错误事件结束流,不会换一个模型续写剩下的答案。聊天界面需要处理「已有部分内容,但请求失败」的状态。
参数兼容同样会决定降级是否成功。原文特别指出,hikyaku 1.6.0 及更早版本的 googleai/ 目的地拒绝包含 max_tokens、temperature、top_p 或 stop 的请求,此时会转给备用模型;部分 OpenAI 模型也拒绝 stop。
有备用模型,只代表多了一条路径;请求参数仍须被备用模型接受。
OpenAI 格式统一了,供应商细节还在
Function calling 的演示中,网关传递 tools 定义和模型返回的 tool_calls,不执行工具。应用自己调用 get_weather,再把 assistant 消息及带有 tool_call_id 的 tool 消息发回。
Gemini 还要求保留 extra_content.google.thought_signature。原文说明 Gemini 3 需要这个签名,所以应用不能只挑标准字段重建 assistant 消息。Gemini 的 call_... 标识由网关补齐,Claude 和 OpenAI 的调用标识则直接透传。
结构化输出使用 response_format,类型为 json_schema。作者演示了把重复扣费投诉分成 team: billing、urgent: true。这展示了一条可运行路径,没有覆盖所有模型和 Schema 的组合。
管理端 :9090 提供 Prometheus /metrics。演示统计里,便宜模型承接 7 次请求,强模型承接 2 次,自动决策执行 2 次,未知名称导致 AI 路由跳过 1 次。hikyaku_model_tokens_total 分别记录各目的地的 input、output token,可用于后续核算。
原文部分响应中,total_tokens 并不等于 prompt_tokens 与 completion_tokens 相加,原因没有解释。因此,仅凭示例里的 token 字段,还算不出可靠的节省比例。
我的判断
我认可把模型选择、密钥和失败策略集中管理。服务多起来后,一份可审查、可测试的配置,确实比每个服务各写一套降级逻辑更容易维护。
自动选模型的收益则需要单独证明。作者没有提供固定用强模型、纯规则路由和 AI 路由之间的成本、质量对照,也没有计入决策模型费用。约 150ms 的额外决策延迟,对长分析任务可能可以接受,对短交互就可能显眼。
原文说低置信度转强模型,让错误只损失金钱而不损失质量,这个判断过满:高置信度也可能选错,供应商故障后还可能从 smart 降到 fast。可用性提高,不等于输出质量不变。
作者建议用五十条真实请求验证。它适合作为起点,不能当成生产保证。文章也没有展开网关自身的部署冗余;集中入口减少了业务接入工作,同时增加了需要维护的公共依赖。
能拿来做什么
- 先按原文建议配置两个名称和一条跨供应商降级链,让一个服务接入,观察一周实际模型、token 用量和失败记录,再决定是否启用
auto。 - 从自己的查询、改写、代码生成和分析请求中整理标注集,把路由测试接入 CI,同时检查最终回答质量,避免只验证「分到了预期模型」。
- 给聊天前端补齐流中断状态,并用故障注入检查重试等待和错误提示;涉及工具调用时,完整保留返回的 assistant 消息及签名字段。
- 在 Node 等业务服务接入前,核对正常模型与备用模型对
max_tokens、temperature、top_p、stop和 JSON Schema 的支持情况,再核算自动路由的完整费用。