用评测驱动 RAG 智能体逐步迭代
教程使用 TypeScript 与 Vercel AI SDK,构建包含一个模型、三个工具和执行循环的法规检索智能体,并通过 HTTP 分离评测与智能体服务。作者报告评测分数从 0.582 升至 0.729,自信但错误的回答从 5 次降至 0 次。
AI 深度解读
给 RAG 接上搜索,并不保证回答更准。这篇教程用 TypeScript 和 Vercel AI SDK 搭建新西兰税法问答 Agent:一个模型、三个工具,加上反复搜索和阅读的循环。作者报告,迭代后的评分从 0.582 提升到 0.729,「自信地答错」从 5 次降到 0 次。
值得看的不只是 Agent 怎么写,而是怎么证明它有用:先测不用工具的模型,再逐项改动,把质量、波动、时间和费用放在一起判断。对正在做知识库问答的开发者,这比继续堆工具更有参考价值。
为什么接上搜索,回答反而可能变差
作者在教程所依托的主项目里,先比较了找资料和推理各自的作用。对照组很简单:一次模型调用,不给工具,只靠模型已有知识回答,文中称为 floor。
结果并不符合「检索一定更可靠」的直觉。直接提供正确资料,没有超过模型自己的记忆;只搜索一次,表现还变差了。只有让 Agent 自己搜索、阅读,再决定是否继续查找,才超过对照组。不过,前两种方案没有包含在教程仓库里,原文也没给出完整的逐项分数。
原因可以这样理解:搜到相关片段,距离回答问题还有一段路。税法问题可能需要找到另一条规定,读完例外条件,再回头修正判断。一次搜索提前固定了资料范围,Agent 循环则允许模型根据刚读到的内容继续找证据。这是对设计的解释,原文没有把每种失败原因逐一验证。
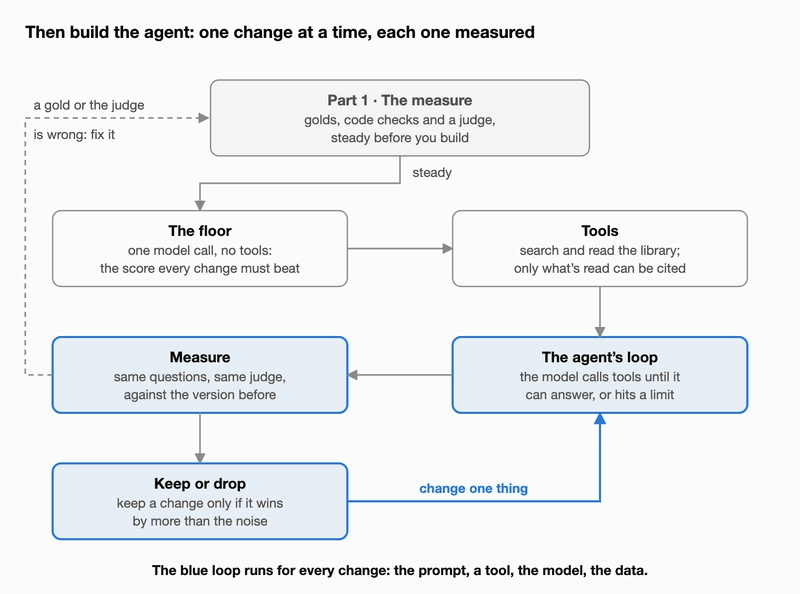
仓库把 harness/ 和 agent/ 分开运行,两者只通过 HTTP 通信。这样评测器可以保持不变,Agent 则独立替换实现。
教程用 18 道题,每题回答 3 次。运行 TOOLS=none PORT=8788 npm start 可以启动无工具对照组,再用 npm run eval -- --agent http://localhost:8788 --name floor --runs 3 评测。命令会先显示预计费用并暂停,加上 --yes 才执行。
先确认原始模型能做到什么,才能判断检索增加的复杂度是否划算。
三个工具,为什么要把搜索和引用分开
这个 Agent 的知识库只有三部税法,存放在 SQLite 中。npm run seed 会复制预建库,包含 5,694 个文本片段及其向量;npm run seed -- --fresh 会重新下载法律并生成全部嵌入,作者给出的耗时约一分钟、费用约 $0.20。
默认检索走 SQLite 全文索引。设置 EMBEDDINGS=auto 才切换到语义搜索,每次搜索前都要先为查询生成向量。原文没有证明向量检索优于默认方案,因此不能把这个开关当成必选优化。
三个默认工具各管一件事:
library_search根据标题或覆盖内容寻找法案,返回内容不能引用。passage_search根据查询、精确词语或条款编号搜索,每条命中返回前 300 个字符,也不能引用。library_read读取完整条款或法案提纲,只有它的返回内容能作为依据,以[extract:L1]这样的格式引用。
这里最有用的设计,是把「发现线索」和「取得证据」分开。搜索摘要帮助模型决定往哪里走,完整阅读才提供回答依据,减少拿半截条款直接下结论的机会。
工具描述也不是装饰。模型靠它理解工具何时该用、参数怎么传、结果是什么。作者建议像设计 API 一样设计工具:职责单一,参数清晰,数量保持克制。工具失败也应返回模型能够据此采取下一步行动的信息。
需要库外法律或官方指引时,可以设置 TOOLS=library,web,增加 web_search 和 web_read,其中网页搜索需要 Firecrawl key。但作者的实验里,网页搜索费用达到 3×,没有带来明确收益。工具更多,不代表这套题答得更好。
循环很短,评测和停止条件才是难点
作者使用 ReAct,也就是让模型根据观察结果交替推理和行动的方式,名称来自 2022 年的论文。落到代码上,就是模型调用工具、读取返回值,再决定继续查还是回答。
这段代码展示了循环入口,以及工具调用如何受到预算约束:
// agent/src/agent.ts, trimmed: the floor's call, with tools and a way to stop
const result = await generateText({
  model,
  instructions: instructionsFor(names, today),
  messages: [{ role: "user", content: questionMessage(question, country) }],
  tools,                                                   // library_search, passage_search, library_read
  stopWhen: [isStepCount(limits.rounds + 1), overBudget],  // 40 rounds of tools, or $3
  prepareStep,                                             // after the last round: tools off, so it must answer
});
要看的是 stopWhen 和 prepareStep:前者参与控制终止条件,后者在最后一轮关闭工具,让模型根据已有材料作答。原文还提到独立计时器,不能把代码中的步数和预算条件当成全部限制。
这些配置集中在 agent/.env,便于每次只改一个变量:
OPENAI_API_KEY=        # the only one you must fill in
MODEL=gpt-6.1-sol      # one model for everything
MODEL_EFFORT=medium
TOOLS=library          # none = the floor; library,web adds the web tools
RUN_ROUNDS=40          # when a run must stop: rounds of tool calls,
RUN_SECONDS=480        # seconds,
RUN_DOLLARS=3          # or dollars
EMBEDDINGS=off         # auto: search by meaning with the library's vectors
这里要一起看 RUN_ROUNDS、RUN_SECONDS 和 RUN_DOLLARS:每个回答最多 40 轮、480 秒,也就是 8 分钟,以及 $3。连续三步没有新发现时,系统还会提醒模型作答或改变方法。关闭工具能终止搜索,但不能保证最终答案正确。
评测也有波动。作者主项目使用 58 道题、每题 3 个回答,未修改实现的三次运行,整体分数仍相差 0.013;逐题比较的差异范围是 −0.039 到 +0.027。因此,他把约 0.03 当作值得相信的提升幅度。这是该项目的经验门槛,不能直接复制到其他题集。
修改后,作者用 npm run eval -- --name agent-my-change --runs 3 --yes 单独命名运行,再通过 results/report.html 比较胜负、持平和判定变化。单独增加写作模型,费用多了 59%,分数最多只提高 +0.008,也被放弃。
生产运行还要留下证据。仓库在 agent/runs/ 为每个回答保存一份 JSON,记录回答、步骤和评判,便于复查或利用已有记录重新评分。作者建议通过 @ai-sdk/otel 的 OpenTelemetry 和 registerTelemetry 接入追踪,监控单次费用、触及限制和工具错误;长任务则可考虑 Temporal 或基于 Vercel Workflow DevKit 的 WorkflowAgent,支持重启后继续执行。
我的判断
这套方案最值得借鉴的是实验顺序:先有对照组,再给工具,然后一次只改一件事。搜索结果不能直接引用,也是一条具体、容易检查的约束,比笼统要求模型「严谨回答」更容易落地。
但「production-grade」需要打个问号。三部税法、18 道教程题,以及主项目的 58 道题,足以展示方法,覆盖不了一般团队的数据规模和线上问题分布。0.582 → 0.729 与错误次数下降是作者报告的结果,输入没有完整评分定义、明细和全部对照数据,不能据此承诺自己的知识库也会获得相近提升。
作者认为,资料缺失、过期或切分不当,比他尝试过的提示词修改更伤效果。这是有价值的经验,但原文没给出这些因素的独立对照。
如果问题固定、一次检索就能拿到完整答案,固定工作流仍然值得作为对照。Agent 的价值在于可以继续调查,代价则是更多调用、延迟和失败路径。原文证明的是它在作者任务中胜出,没有证明所有 RAG 都应该循环。
安全措施同样有边界。作者要求把工具结果当数据,并用 PLANTS=on 植入攻击页面测试;这可以检查提示注入行为,却不能仅凭结果前的一句提醒就断言防护充分。模型可替换也是如此:示例给出 npm i @ai-sdk/anthropic 和 claude-sonnet-5-5,但切换时还要修改 src/model.ts、配置新价格并重新评测。
能拿来做什么
- 给现有 Node 知识库问答建立两条可比较路径:一次模型调用,以及当前检索方案。使用相同问题重复运行,把质量、时间和费用一起保存,先判断检索是否确实有收益。
- 把搜索预览和完整文档读取拆开,并要求最终引用对应完整读取结果。涉及条款或说明文档时,检查模型是否读到了上下文,再把答案交给用户。
- 给 AI SDK 循环同时设置轮数、时间和金额上限,记录工具参数、返回值及错误。卡住时能定位问题,比只保存最终回答更有用。
- 把
npm test放进每次 PR 检查,发布前运行完整评测。先测自己的波动范围,再决定回退门槛;上线后每周补充少量真实问题和参考答案,持续修正题集。