用反事实回放检验 Agent 是否采信证据
执行日志能记录 Agent 检索了什么、随后做了什么,单凭这些记录难以判断证据是否改变了决策。文章讨论通过受控回放改变证据输入,再比较决策结果,以审计高风险工作流。
AI 深度解读
AI Agent 调过风控工具,拿到高风险结果后拦下交易。执行日志能证明这两件事先后发生,却回答不了一个更实用的问题:把风险评估改成低风险,它还会拦吗?
作者用开源 AI Governance Platform(AIGP)和 OpenAI Responses API 做了两个受控回放实验。一笔交易改判,另一笔因为账户锁定而维持原判。这套方法测的是决策对某项外部证据有多敏感,适合用来排查多工具 Agent 的决策链路。
工具调用成功,为什么还要重跑一次
执行追踪可以还原工具调用顺序、返回值、延迟和错误,也可能记录模型版本和工具配置。拿交易拦截来说,日志里先出现风险评估 HIGH / 0.90,随后出现 BLOCK。这条链路看起来合理,但同一个 BLOCK 也可能由账户锁定独立触发。两项证据同时存在时,单看日志很难判断改掉其中一项,业务结果会不会动。
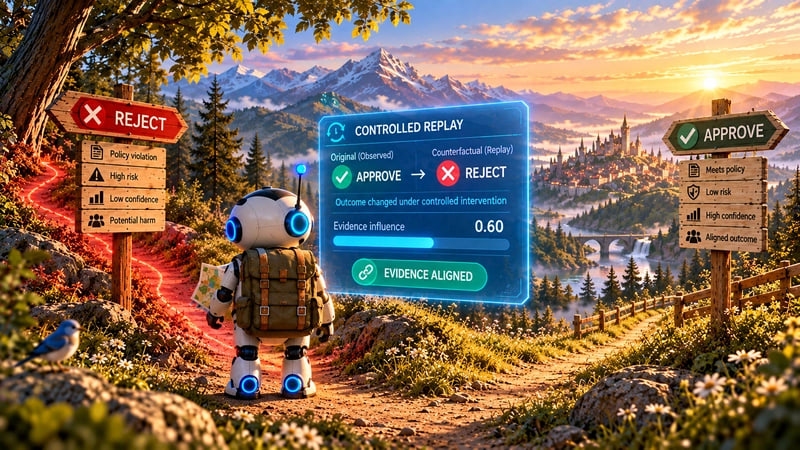
受控反事实回放(controlled counterfactual replay)把这个问题变成一次可检查的实验。保留原执行,在新的一次执行里只替换获准修改的工具证据,例如把风险等级和置信度一并改为 LOW / 0.20,其余相关输入尽量保持一致,再比较业务结果。这里改动的是一份风险评估里的两个字段,所以即使结果翻转,也只能判断这次组合改动产生了影响,无法单独归因到等级或置信度。
作者用真实模型调用跑了两个参考场景。第一个场景从 HIGH / 0.90 下的 BLOCK 变成 LOW / 0.20 下的 ALLOW,实验表明该场景的判定对这次替换敏感。第二个场景额外提供了账户锁定事实,风险评估变化后仍然返回 BLOCK。账户锁定足以维持原判,风控结果是否还影响了执行中的其他行为,这次比较回答不了。
回放能不能复核,取决于谁保管状态、谁批准改动
AIGP 把流程拆成 4 步。Observe 在执行结束后记录有序的工具调用标识、获准使用的证据引用、schema 信息和取值范围受限的结果分数。Authorize 选用处于生效状态的版本化策略,确认某份证据允许怎么改。Replay 通过已注册的兼容适配器,在隔离环境中交给原运行时执行。Compare 比较结果并保存审计记录,让复核者能追到原执行、策略版本、回放执行和各自的结果测量。
策略支持 NULLIFY、REPLACE 和 PERTURB,分别对应置空、替换和扰动,具体能怎么改取决于策略和证据契约。参考实验走的是 REPLACE。系统对规范化的 JSON 计算摘要,把获准替换的证据和回放请求绑定起来。运行时解析出替换内容后核对摘要,内容对不上就拒绝执行。每次反事实回放有独立的执行标识和证据记录,原始执行可继续作为后续实验的基线。
Agent 运行时保管私有提示词、工具参数和返回值等重建所需的信息,也负责安全执行回放。治理控制面负责审批干预、检查执行是否符合条件、协调回放任务和记录结果。参考实现把 OpenAI SDK 留在 AIGP Core 之外,外部运行时通过版本化的 Plugin API 接入。OpenAI Responses API 的默认续接模式使用 store=false 发起无状态请求,需要原生响应续接时可切换到由服务商保管状态的模式。采用默认模式时,重建上下文仍然是运行时的责任。
审计标签看的是结果差异和工具调用
AIGP 将原执行的结果分数与成功回放的聚合分数比较,由配置阈值决定差异是否够大。文章没有给出实验的回放样本数、阈值数值或具体聚合方法。标签表达的是在既定指标和条件下测到了什么。
EVIDENCE_ALIGNED表示证据改动显著影响了测量结果,工具调用也处于配置范围内。参考实验中,交易从BLOCK翻到ALLOW的场景演示了这一类。EVIDENCE_IGNORED表示获准改动没有显著改变测量结果。账户锁定场景演示了这一类,读这个标签时要把独立约束一起考虑进去。OVER_EXTENDED表示测到了证据影响,但结果基本确定后,Agent 仍继续发起不必要的工具调用。NO_TOOL_EVIDENCE表示缺少可供评估的工具证据。前置条件缺失、适配器不兼容或样本重跑失败时,系统也会保留这些局限,供复核时查看。
我的判断
我认同作者把审计落在可观察的业务结果上。对程序员来说,「这份证据改了以后,BLOCK 会不会变成 ALLOW」比读一段模型给出的理由更容易验证。但两个参考场景验证的是集成流程和各自的结果。文章没给生产系统的对照数据,也没测出独立治理平台比应用内回放更有效。作者对职责拆分的判断属于工程经验。
单个应用可以先在测试框架里固定一次执行的输入,再替换工具返回值。需要跨多个运行时审批证据改动、管控回放权限和复核历史结果时,独立控制面才有更明确的用处。两种做法都要处理同样的基础问题:依赖服务和工具 schema 会变化,模型同样的输入可能给出不同答案,涉及付款、发通知、写库的工具也必须隔离。重复采样可以帮助判断波动,但会增加 token 消耗、耗时和服务成本。
如果业务规定账户锁定就必须拦截,确定性规则和常规测试可以直接验证这个要求。回放更适合检查模型有裁量空间的那部分决策。EVIDENCE_ALIGNED 表示模型对指定证据变化有反应,至于该不该放行,仍要按业务规则和授权要求单独判断。
能拿来做什么
- 给 Node Agent 的工具层留一个测试入口,用同一份输入和工具契约重放一次决策,只替换目标工具的返回值。比较业务层消费的
ALLOW或BLOCK,避免把回答措辞的变化算作改判。 - 给同一次审计加一组原样回放,先看相同证据下判定会不会自己跳变,再看替换证据后的差异。用例里可以保留一个账户锁定之类的独立条件,验证硬约束生效时结果是否稳定。
- 如果前端已有 Agent 执行详情页,把原判定、替换后的证据、回放判定和失败样本放在同一处展示。回放由测试适配器执行,付款、通知和写库调用接到隔离环境。