百度开放 2800 亿参数 ERNIE 基座
百度发布 ERNIE 5.5 Flash Base,采用 2800 亿参数 MoE 架构,预训练数据规模为 33.5 万亿 token。模型未经微调,为开发者提供后续定制的基座。
AI 深度解读
百度发布的 ERNIE-5.5-Flash-Base,重点在于给开发者提供一个可以继续训练的基础模型。它刻意没有经过微调或后训练;要把它变成能稳定听懂指令、适合具体业务的助手,后续工作需要开发者自己完成。
这次发布值得关注的是模型规模、长上下文设计,以及基础模型的开放权重。但对想直接接入 AI 编程能力的团队来说,参数和榜单之外,更该先弄清楚:拿到的是哪一阶段的模型,距离可用产品还有多少工作。
没有后训练,拿到的模型能做什么
基础模型(Base Model)经过预训练,已经学习了大量文本中的知识和模式。但预训练能力与遵循用户指令、按要求输出结果,并不是同一件事。
原文明确说,ERNIE-5.5-Flash-Base 发布时没有经过微调或后训练,开发者需要自行决定后续训练方向。百度计划之后推出后训练版本,但原文没有给出时间。
这次开放的是继续训练的起点,直接用于助手产品的效果仍需验证。
对于有训练数据、算力和模型工程能力的团队,这样的起点可以用于探索自己的任务方向。对于只想在应用里加入代码问答、文本处理能力的开发者,Base 版本是否合适,需要和已经完成后训练的模型分别评估。
2800 亿参数,为什么每次只激活 140 亿
ERNIE 5.5 使用混合专家架构(MoE),总参数量为 2800 亿,每个输入激活其中的 140 亿,约占总量的 5%。
可以把它理解为:模型内部有多组负责不同计算的专家,每次处理输入时,只调用其中一部分。总参数量描述模型整体规模,激活参数量更接近单次输入涉及的计算规模。
但不能据此把它当成一个部署成本等同于 140 亿参数模型的产品。完整权重如何存储、专家如何分布、运行时需要多少显存,原文都没有交代。
权重已在 Hugging Face 提供 FP8 和 BF16 两种格式。原文没有给出对应硬件配置、吞吐量或部署成本,因此目前能确认的是权重格式,不能进一步推导普通团队能以多低的成本运行它。
百万上下文和基准成绩,要分开看
模型预训练使用了 33.5 万亿 tokens,训练上下文最长为 128,000 tokens。它在设计上支持微调和推理阶段扩展到最多 100 万 tokens。
这里有两个不同层次的信息:128,000 tokens 是原文给出的预训练上下文长度,100 万 tokens 是设计支持的扩展长度。原文没有展开扩展方法,也没有给出百万长度下的具体质量、延迟和资源消耗。
能容纳更长输入,不等于能可靠利用输入里的每一处信息。
百度还提供了与其他开放基础模型的基准比较,称其在推理、代码和长上下文任务上具有竞争力。图表覆盖 Exam、STEM、Reasoning、Knowledge、Code、Multilingual、Long Context 七类任务,并注明使用相同评测流程。
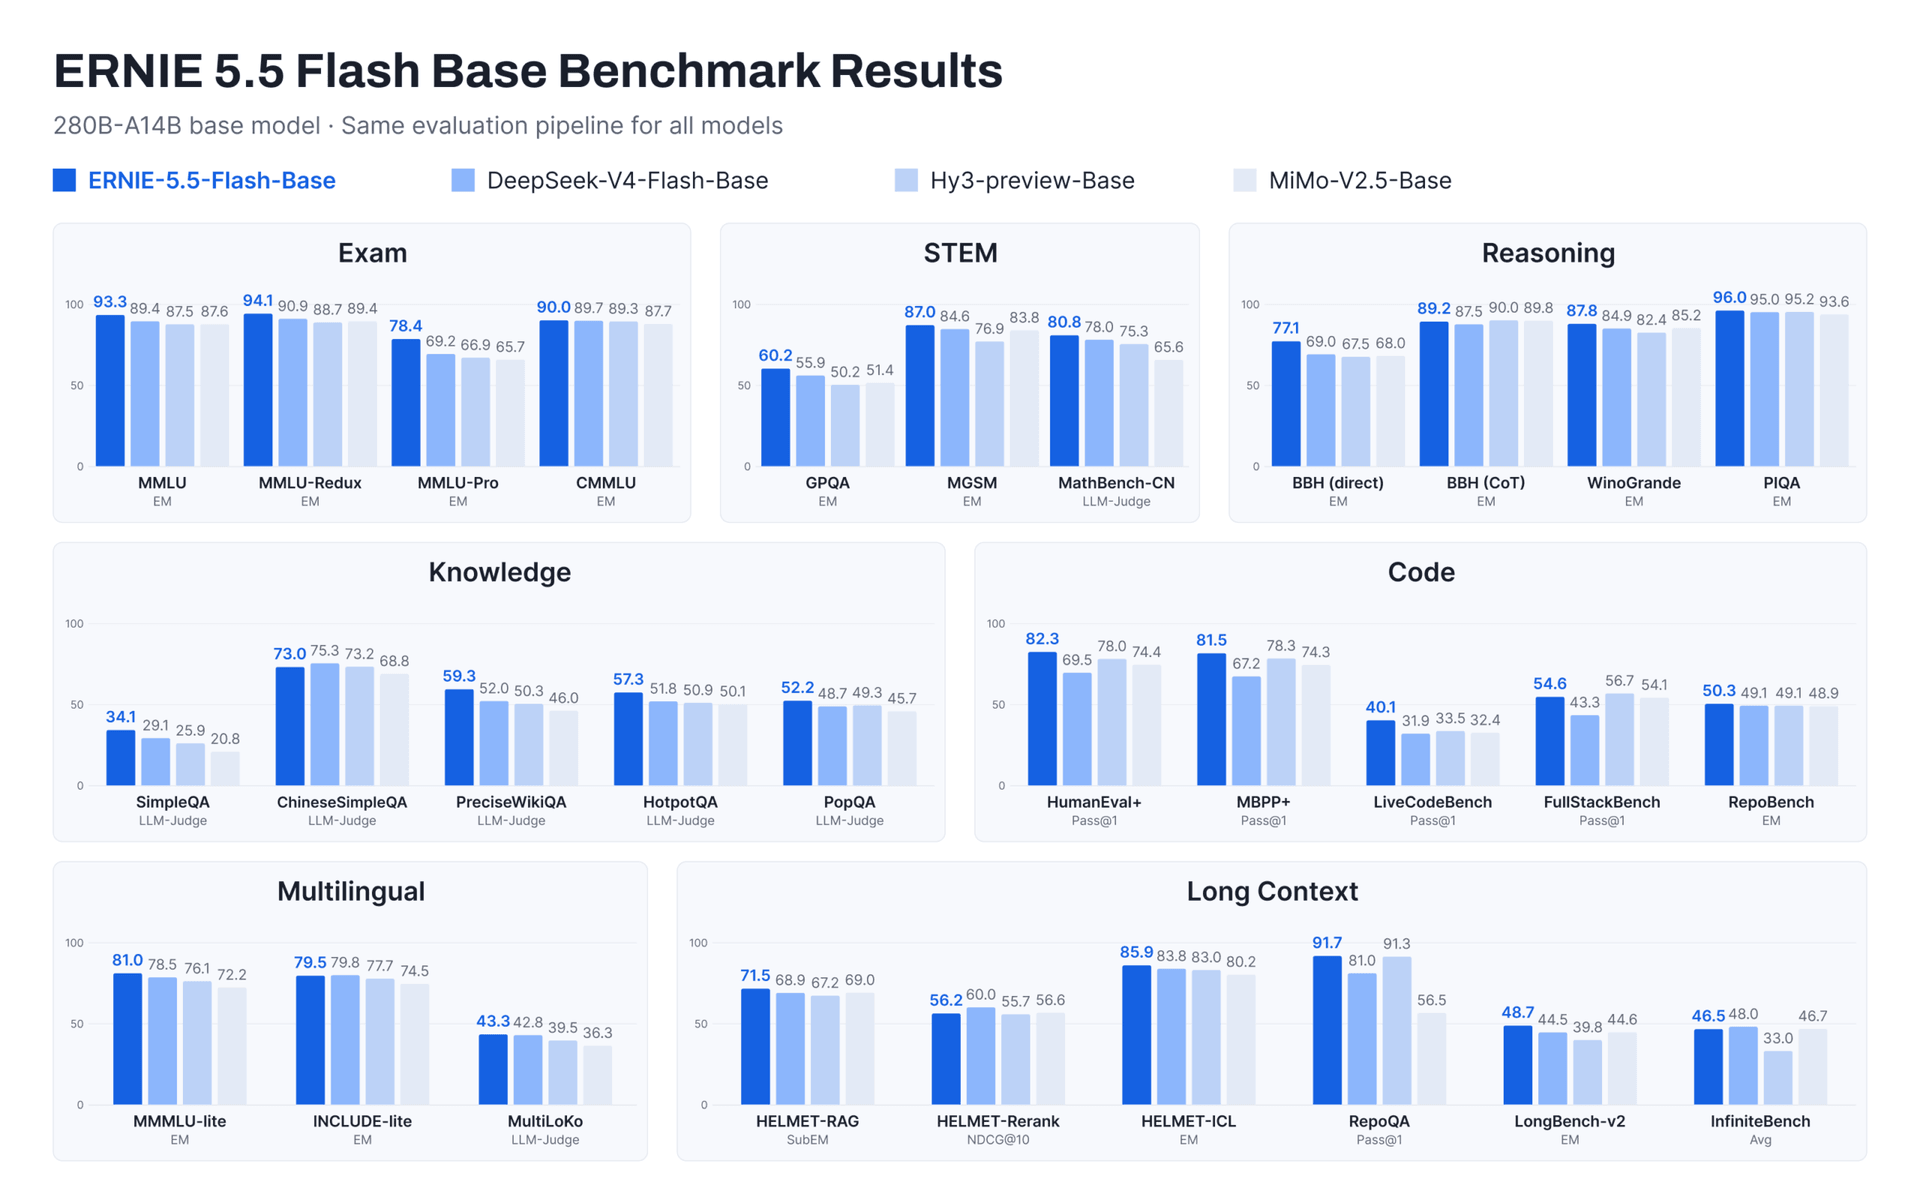
对比对象包括 DeepSeek-V4-Flash-Base、Hy3-preview-Base 和 MiMo-V2.5-Base。统一流程有助于比较,但这些结果来自百度;原文没有提供独立复测,也没有展开评测配置。不能把「具有竞争力」直接读成全面领先,更不能据此认定它已经适合日常 AI 编程。
我的判断
这次发布对模型训练团队的直接价值,比对普通应用开发团队更明确。前者可以围绕一个开放基础模型继续训练,后者通常更关心指令遵循、工具调用和任务完成率,而原文没有提供这些方面的证据。
和直接采用完成后训练的模型相比,选择 Base 版本会把更多训练与验证工作留给团队。是否值得,取决于业务是否需要这种定制空间,以及团队能否承担相应成本。
文章提供了厂商基准图,但缺少独立验证;把它视为有潜力的候选模型是合理的,把它当成已经证实的编程助手替代品则证据不足。另外,标题使用「开源」一词,正文确认了权重可获取,却没有说明许可证和商用条件,具体使用边界仍需核对。
能拿来做什么
- 如果正在选择日常 AI 编程工具,先确认比较的是 Base 版本还是后训练版本,再用相同的代码任务测试,避免只按参数量和代码榜单做选择。
- 如果团队计划训练自己的代码模型,可以把 ERNIE-5.5-Flash-Base 纳入候选,先核对许可证、FP8/BF16 运行支持和部署资源,再决定是否投入训练。
- 如果关注整仓代码或长文档处理,可以围绕实际输入长度测试信息定位和跨文件推理,并记录延迟与资源消耗,不把 100 万 tokens 的设计上限当作效果保证。