实测 AgentCore 整场摘要与分块摘要
Amazon Bedrock AgentCore Memory 现在会在分块摘要之外,自动为整个会话生成一条摘要记录。文章对比两种输出的行为和适用场景,讨论长对话中的上下文长度与细节保留问题。
AI 深度解读
Amazon Bedrock AgentCore Memory 现在会为同一场会话生成两种摘要:按批次记录对话的 chunk,以及持续更新的全会话摘要。前者方便找某一段聊过什么,后者更适合把整场对话交给下一个 Agent。
作者用耳机售后和酒店预订做了对比。全会话摘要确实能把前后分散的地址信息合到一起,但也会继承 chunk 里的事实错误。更容易被接入方忽略的是,同一批会话事件提交后,早一点和晚一点读摘要,答题结果可能差不少。
同一个话题聊了两次,为什么会留下两份记录?
据原文引用的 2026 年 11 月 17 日公告,AgentCore Memory 的 summary 策略会在 chunk 之外自动生成一条全会话摘要。chunk 按事件批次生成,旧 chunk 不会被改写。后面再聊到之前的话题,新 chunk 会另开一个 <topic>,只记这一批新增的信息。全会话摘要则把新 chunk 融入已有记录,形成一份覆盖当前会话的滚动摘要。作者实测看到,全会话摘要在原记录上更新。
耳机售后的例子很直观。作者把 18 条事件分成前 8 条和后 10 条提交。第一批里,客户申请把收货地址从东京品川区改到大阪市北区,客服给了验证码 7391。第二批里,双方又确认了一次新地址。两份 chunk 分别记下「修改地址」和「确认地址」,全会话摘要则把它们合成一节,同时保留验证码。接手这个会话的 Agent 可以直接读到当前地址和确认结果。
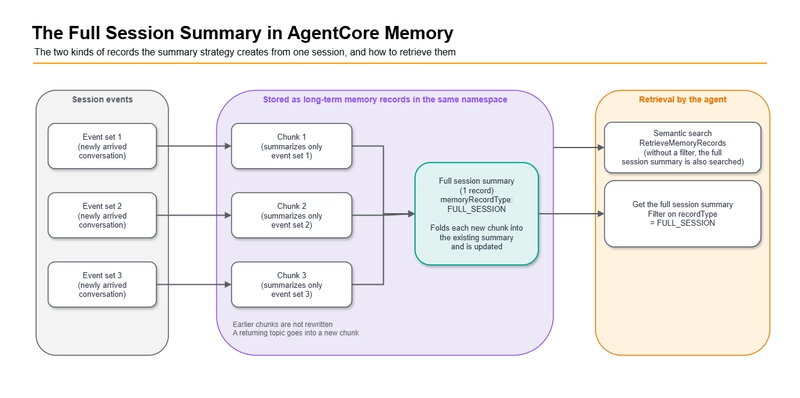
全会话摘要只由 summary 策略生成,命名空间需要包含 session ID。AgentCore Memory 有四种内置策略。semantic 和 user preference 默认按用户(actor)组织,episodic 可以选策略级、用户级或会话级,summary 按会话工作。同一个 memory 可以组合多个策略,未配置策略时不会产出长期记忆记录。
下面的 AWS CLI 命令只取指定会话的全会话摘要:
aws bedrock-agentcore list-memory-records \
  --memory-id "<memory-id>" \
  --namespace "/strategy/<memory-strategy-id>/actor/<actor-id>/session/<session-id>/" \
  --metadata-filters '[
    {
      "left":     {"metadataKey": "x-amz-agentcore-memory-recordType"},
      "operator": "EQUALS_TO",
      "right":    {"metadataValue": {"stringValue": "FULL_SESSION"}}
    }
  ]'
过滤器用 EQUALS_TO 匹配系统生成的 x-amz-agentcore-memory-recordType。作者还观察到,chunk 的记录类型是 BASE,示例内容采用 XML <topic> 结构,全会话摘要则用了 Markdown。原文特意说明,BASE 来自这次观察,文档没有描述这个值。
4 个 chunk 到 5 个 chunk,为什么答题差这么多?
作者在 2026 年 11 月 18 日于东京区域 ap-northeast-1 用 boto3 调用 API,对比三种回答上下文:完整对话、拼接所有 chunk,以及全会话摘要。回答模型是 jp.anthropic.claude-haiku-4-5-20251001-v1:0,temperature 为 0。输入 token 计数包含系统提示词和问题。对话和生成的记忆记录都是日语,原文展示的是英译。
18 条事件的售后案例问了 4 个细节和 2 个状态问题,每题跑 3 次。细节包括订单号 XYZ-48213、11 月 20 日的计划发货日期、800 积分和验证码 7391。状态题问客户还要做什么,以及双方已经谈妥了什么。酒店预订案例有 56 条事件,围绕 14 个细节各问一次,整组跑 2 次。评分脚本检查答案是否包含预埋的正确关键词。
酒店会话提交完约 47 秒时,作者读到 4 个 chunk,拼接摘要和全会话摘要都得了 20/28。第 5 个 chunk 出现后再跑,两者都升到 26/28。作者观察到,分块边界有时落在问题和回答之间,前一块会写「尚未确认答复」,后续块才补上回答。提交完事件和摘要处理完事件,是接入时要分别看待的两个时间点。约 47 秒只是这次实验的取数时点。
第 5 个 chunk 也没修复所有问题。酒店客服说,提前寄送的行李可以到前台领取,地址标签要写住客姓名和入住日期。第 4 个 chunk 却把这段答复记到了发票下面,又把行李问题记成尚无明确答复。全会话摘要把发票那条错误一起收了进去。原文给出的全会话摘要长度为 939 字符。这个案例里,拼接 chunk 的字符数和 token 数都超过了完整对话,作者怀疑有内容重复,但没有单独验证原因。
我的判断
全会话摘要最有说服力的用途是交接。地址改到哪、用户还欠哪个动作、客服已经承诺了什么,这些信息可能散落在几十条消息里。整理到一条记录后,接手方更容易找到当前状态。AWS 文档明确提到的也是用单条记录交接会话上下文。作者对其他适用场景的推断,可以当接入经验看。
要决定是否用摘要替代完整历史,这组实验还不够。它覆盖两段日语会话和一个回答模型,关键词命中能测订单号之类的细节,却可能漏掉「地点对了,事项归错了」这种问题。给出的原文也没有列出 18 条事件那组的完整成绩和三种方案的具体 token 数,能确认的是酒店案例的两次得分和输入长度的相对关系。重叠导致 chunk 膨胀的解释仍是作者的推测。
短会话如果放得进输入预算,直接带完整历史能保留问答原句。会话变长、页面又只需要交接概览时,全会话摘要更省整理工作。碰到地址、验证码或实际办理状态,应用已有的业务字段或原始消息更适合用来核对。酒店案例里,摘要语句读起来很连贯,真正错的是它把一条正确答复接到了另一件事上。
能拿来做什么
- 给客服工作台做「接手会话」视图时,可以在 Node 后端按 actor 和 session 拉取
FULL_SESSION,让前端展示会话概览,并保留查看原消息的入口。 - 提交最后一批事件后,如果交接视图要反映刚确认的承诺,可以在后续读取时重新取摘要。用真实会话测一遍更新延迟,别把实验中的 47 秒写成固定等待时间。
- 评估接入效果时,把细节题和状态题分开记分,再加一类「答复对应哪个事项」的题。比如同时追问行李领取地点和发票抬头,检查模型有没有把两件事混在一起。
- 用自己的会话样本比较完整历史、拼接 chunk 和全会话摘要,记录实际输入 token 数。样本里放几段来回切换话题的对话,这比只测从头聊到尾的单一主题更容易发现归并错误。