用异步任务接口让智能体告别阻塞等待
文章将阻塞式工具调用拆为 start、status、stop 接口,任务结果通过后续事件返回,让智能体在长任务执行期间继续接收指令。内容涉及任务契约、结果回传与取消机制。
AI 深度解读
AI 编程助手跑测试时,为什么连一句追问都接不住?这篇文章把问题指向 agent 的执行循环:慢工具占住了当前轮次,后面的消息只能排队。作者提出,把阻塞的 run() 拆成启动、查状态和取消,让后台任务继续跑,agent 继续回应用户。
这个方案适合构建、测试、部署等长任务,但换个函数名远远不够。真正需要补齐的是任务 API、结果事件、取消语义和重试保护。文章也给出了内部实验数据,不过这些数据能证明什么,需要分开看。
跑测试的时候,agent 为什么不能继续聊天
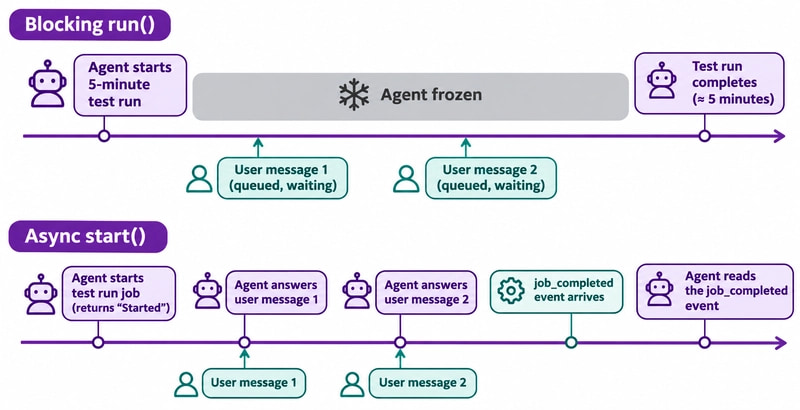
原文先后举了 6 分钟测试和 5 分钟测试的例子:用户启动测试后,又问了一个模块导入错误。这个问题不依赖测试结果,却仍然要等前面的工具调用结束。
阻塞带来的损失不只是等待。两分钟后,用户改口说跳过 e2e,agent 可能还没机会读取新指令;长连接也可能被网关超时切断,出现后台已经成功、调用方却收到失败的情况。对于 200 ms 的查询,这些问题不突出;对于部署或爬取,就很影响使用。
作者的方案是让 start() 立即返回任务句柄,也就是后续查状态、取结果要用的任务 ID。agent 记录它并结束当前轮次,runtime 在后台等待,完成后再把事件送入对话。
异步工具调用的关键,是把等待任务从模型当前轮次移交给 runtime。
这和并行工具调用有区别。并行是在一轮里同时跑多个工具,模型仍然等它们结束;异步允许任务跨轮次完成,期间继续处理用户消息。
原文借用了 DeepSeek Harness 文章里的「全双工」(full-duplex)说法,但也交代了边界:相关架构已经实现,尚未默认启用;dsh-superagent-prototype 是原型插件,作者声明它不是 DeepSeek 官方产品。这里可借鉴的是设计思路,不能当成一个现成产品开关。
start() 返回以后,谁把结果送回来
作者建议为慢任务提供三类工具:start_test_run 启动,get_job_status(job_id) 查询,stop_job(job_id) 请求取消。
启动接口只返回 {"job_id": "job_8f2", "status": "queued"}。输入里的 suite 可选 unit、e2e、all,并要求传入 idempotency_key。状态查询返回 queued、running、done 或 failed,附带简短进度。
这里有两个容易漏掉的约定:工具描述明确写上 do not wait,避免模型立即循环查状态;启动结果始终保持同一种结构,不要有时返回任务 ID,有时又直接返回完整结果。
后台任务完成后,由 runtime 注入一条短事件:
[event] job_completed job_id=job_8f2 tool=start_test_run status=done
summary: 412 passed, 3 failed (auth/session.test.ts)
details: get_job_result(job_8f2)
重点看 details 这一行:模型先读摘要,需要排查时再调用 get_job_result。示例里的 412 个通过、3 个失败用于展示消息格式,不是作者提供的测试成绩。40,000 行日志也不该一次性塞进上下文。
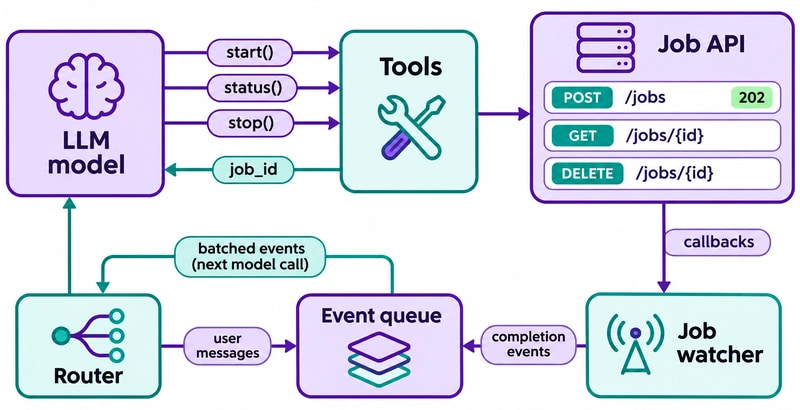
runtime 里的任务监控器可以轮询 job API,也可以接收回调。模型生成回复期间,新事件和用户消息先排队,当前轮次结束后,再按到达顺序一起送进下一次模型调用。
原文转述的 DeepSeek 内部实验中,触发频率从每分钟 1 次增至 40 次,平均批大小从 1.0 增至 2.8,单次决策耗时从 6.4 秒降至 1.6 秒。作者把收益联系到合并输入和预填充(prefill),但没有给出足够实验细节。它说明批处理值得尝试,不能据此承诺一般团队也能获得同样降幅。
真正难的是任务生命周期,不是异步语法
前端和 Node 开发者熟悉 async/await,但函数内部异步,不代表 agent 已经能接收下一条消息。后端必须真的接受任务、返回 ID,并允许后续查询。
原文给出的 HTTP 契约是:POST /jobs 返回 202 Accepted 和 job_id,表示已接受但尚未完成;GET /jobs/{id} 查询状态;DELETE /jobs/{id} 请求取消。
还需要处理几类边界:
- 任务可能乱序完成。B 依赖 A,就等 A 的完成事件再启动 B,或者由 API 提供
depends_on。 stop()只是请求。取消与完成可能同时发生,最终状态应如实返回cancelled或done。- 模型会重试。相同
idempotency_key必须返回已有任务,避免迁移等操作执行两次;HTTP 示例使用Idempotency-Key。 - 长任务可以通过
get_job_result(job_id, cursor)分页提供部分结果,例如先取爬虫抓到的 50 页;超时则发送job_timed_out,已处理任务压缩成一行摘要。
原文还称 MCP 版本 2026-07-28 将 Tasks 列为可选扩展:tools/call 可返回带 taskId 的 CreateTaskResult,通过 tasks/get 查询或监听 notifications/tasks,用 tasks/cancel 请求取消。状态包括 working、input_required、completed、failed、cancelled。这些是原文给出的规格信息,客户端和服务端都要支持,不能默认所有 host 都可用。
文章后半段转向 Apidog CLI,建议先验证 job API。安装命令原样如下:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
注意最后一行需要选择对应 agent。原文随后让 agent 先执行 apidog cli-schema get endpoint-create,再用 apidog cli-schema validate endpoint-create --file post-jobs.json 校验,最后执行 apidog endpoint create --project <projectId> --file post-jobs.json。
测试用例同样先执行 apidog cli-schema get test-case-create,再执行 apidog cli-schema validate test-case-create --file case-create-202.json 和 apidog test-case create --project <projectId> --file case-create-202.json,最终用 apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json 运行。
断言包括创建返回 202 和 ID、60 秒内到达 done、重复幂等键返回同一 ID,以及取消后读取结果返回 409 或 404。通过后可在 CI 使用 -r junit。原文称免费套餐支持最多 4 人,但没有提供这套流程实际执行后的报告。
我的判断
我认同它对交互问题的定位。长测试与后续提问互不依赖,却被绑在同一轮等待里,确实是 agent 调度层需要解决的问题。
但 do not wait 只是模型提示,运行时仍要承担可靠的队列、任务状态和事件投递。文章没有讲清进程重启后如何恢复、重复事件如何处理,也没有给出取消失败和状态竞争的完整实现。生产落地时,这些缺口都要补上。
取消后的 409 或 404 也只是示例契约。既然取消是协作式的,任务可能已经完成,测试就需要覆盖这条分支,不能把「请求取消」直接断言成「结果消失」。
相比所有调用都异步化,保留快速查询的阻塞流程更省事。原文建议一两秒内完成、下一步必须依赖结果的调用继续阻塞,这个取舍合理。不过,是否异步应该看耗时和交互需求,不能只按读写划分,长时间爬取同样需要后台任务。
至于批处理收益和 Apidog 的工具选择,前者只有内部数据,后者没有替代方案对照。它们可以作为实现参考,尚不足以证明某个工具或架构组合最优。
能拿来做什么
- 给现有 AI 编程助手检查一次等待链路:先挑测试、构建或部署中的一种长任务,验证运行期间能否接收并处理一条无依赖的追问。
- 在 Node 服务里先做完整的 job API,覆盖重复启动、完成与取消竞争、超时和结果分页,再把接口包装成模型工具。
- 给测试结果设计短事件,只发送通过数、失败数和关键文件,把完整日志留给
get_job_result按需读取。 - 评估 MCP Tasks 时,先核对实际 host 与服务端支持;暂不支持时,也可以用任务 ID 和 runtime 完成事件实现同样的交互流程。