智能体记忆设计:筛选比堆积更有效
据报道,Anthropic 的跨会话记忆研究发现,精简策略笔记比完整归档更有效,宝可梦测试中也观察到明显进展差异。其“Dreaming”流程还会回溯修正错误记忆,但摘要中的对比同时涉及模型版本变化。
AI 深度解读
Agent 能把昨天的工作接着做下去,靠的未必是更大的记忆库。Anthropic 的一组实验发现,记住经过验证的策略和规则,比保存每一步操作更有用;错误笔记还可能让 Agent 在后续会话里反复踩坑。
他们提出的 Dreaming,是让 Claude 在会话结束后回看记录、纠正笔记,再整理成可复用的知识。对日常使用 AI 编程的人,这篇最有价值的部分,是解释了长期记忆该存什么、何时整理,以及为什么不能把历史记录直接塞进上下文。
为什么记得越多,任务反而做得越差
这里的记忆不涉及重新训练模型。Claude 的模型保持不变,只是把信息写进文件夹,下次会话再读取。难点在于:记录发生时,Agent 还不知道未来会遇到什么任务,只能提前判断哪些信息值得留下。
Anthropic 用 Pokémon Red 做了对比。较早的 Claude Sonnet 3.7 在约 10,000 个游戏步骤中,创建了 225 个文件夹、413 个文件,累计约 978,000 个字符。战斗、物品都可能单独记一份。游戏状态不断变化,笔记很快过时,模型有时忙着整理文件,最后只拿到 1 枚徽章。
原文称为 Claude Fable 5 的较新模型,只留下 10 个文件、约 43,000 个字符,拿到了 4 枚徽章。它不重复记录屏幕上已经能看到的信息,主要保存计划、策略和经过验证的规则。
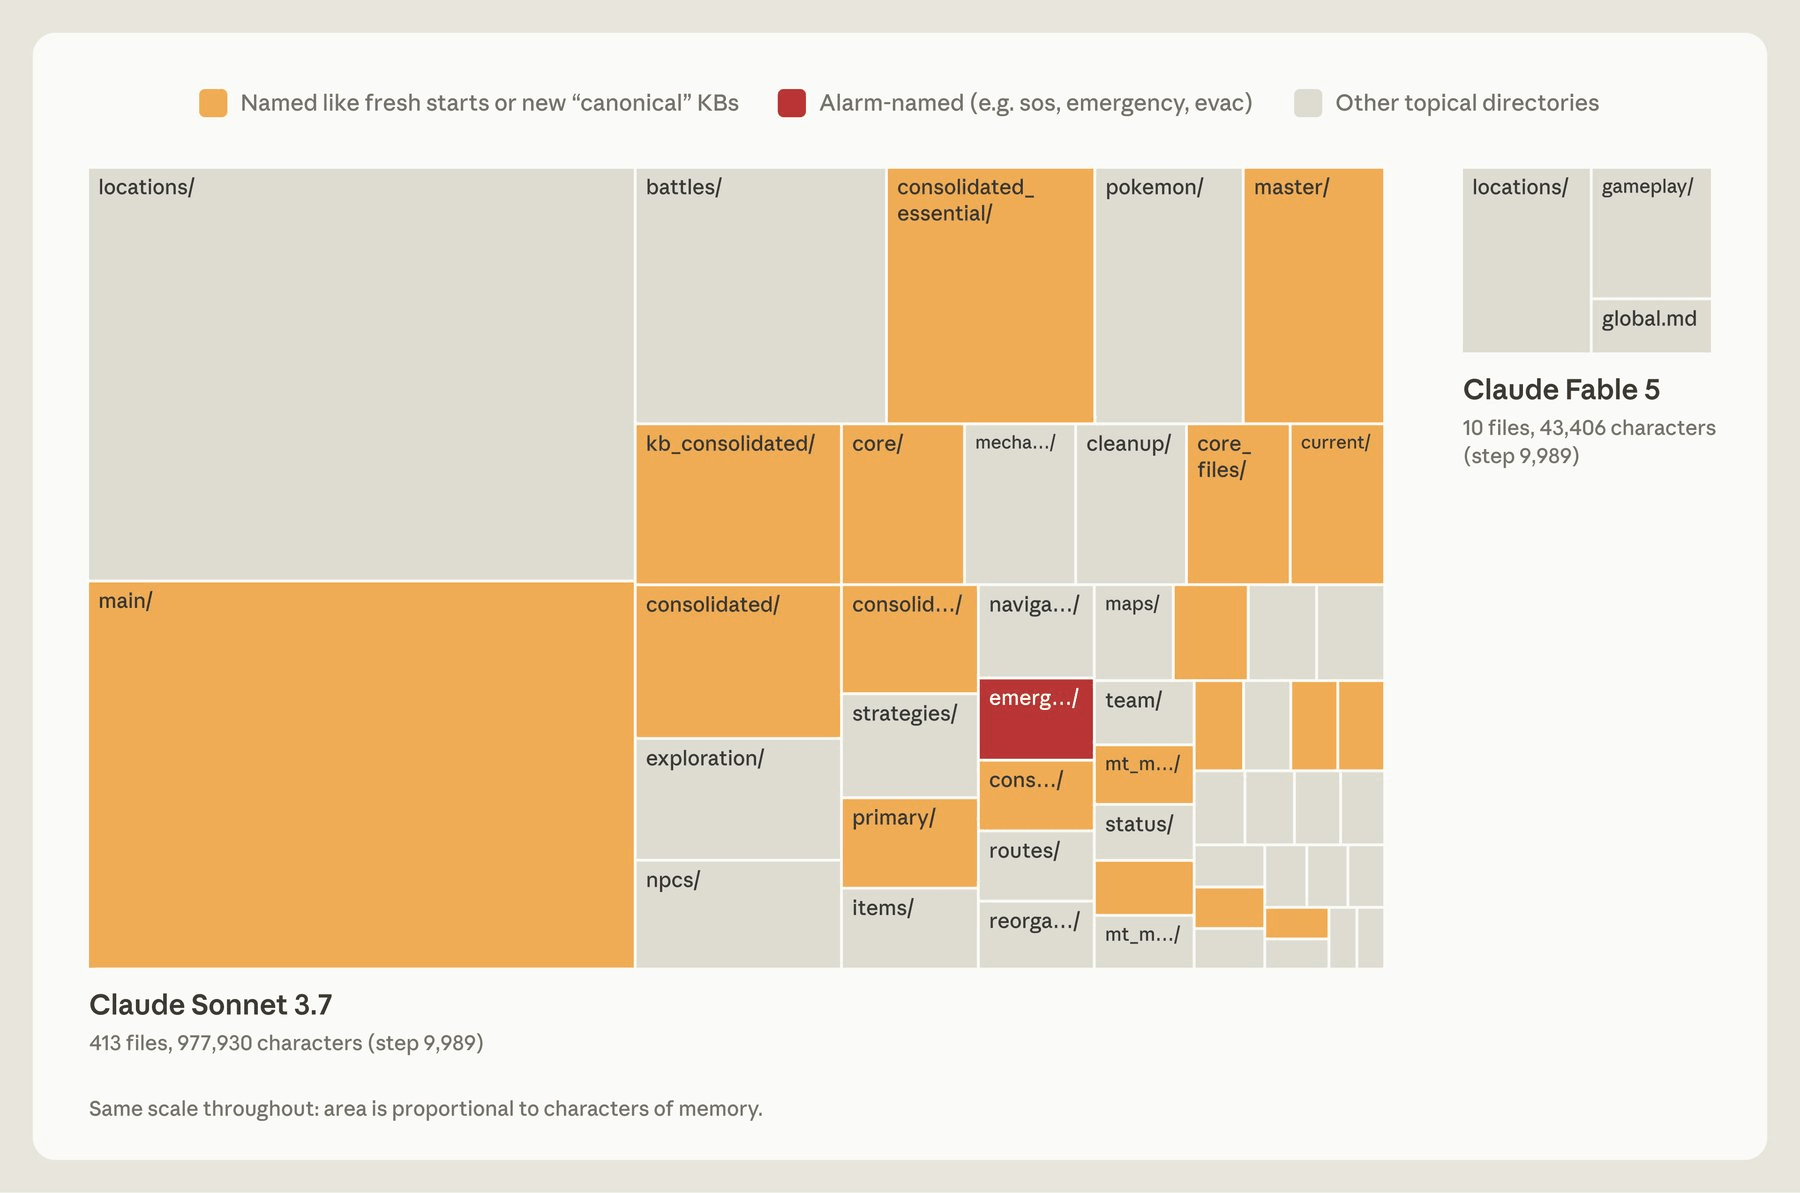
有用的记忆,是未来能指导行动的信息。
不过,这组对比每个模型只跑了一次,而且模型本身不同。它能说明两种记录行为与任务表现同时出现,不能证明仅靠减少文件,就能从 1 枚徽章提升到 4 枚。
提示词也没有统一答案。一个基准中,Sonnet 4.6 不用记忆得分为 0.330,使用记忆为 0.364,配合改进指令后达到 0.641。较早模型需要明确提醒,例如每次回答前先读笔记;较强模型若被限制为「只记录错误」,记忆带来的大部分优势反而消失了。
作者据此建议,先解释记忆的用途,再让模型决定怎么用。但这仍是特定基准里的观察,不能直接推成所有模型都适用的提示词规则。
Dreaming 怎么把错误笔记纠正回来
比信息太多更麻烦的,是错误信息被当成事实反复使用。
游戏实验中,Claude 把一个地标记在了山的错误一侧。后续行动依赖这条笔记,连续三次掉进同一个陷阱,甚至想放弃任务。错误一旦写进长期记忆,就可能跨会话延续。
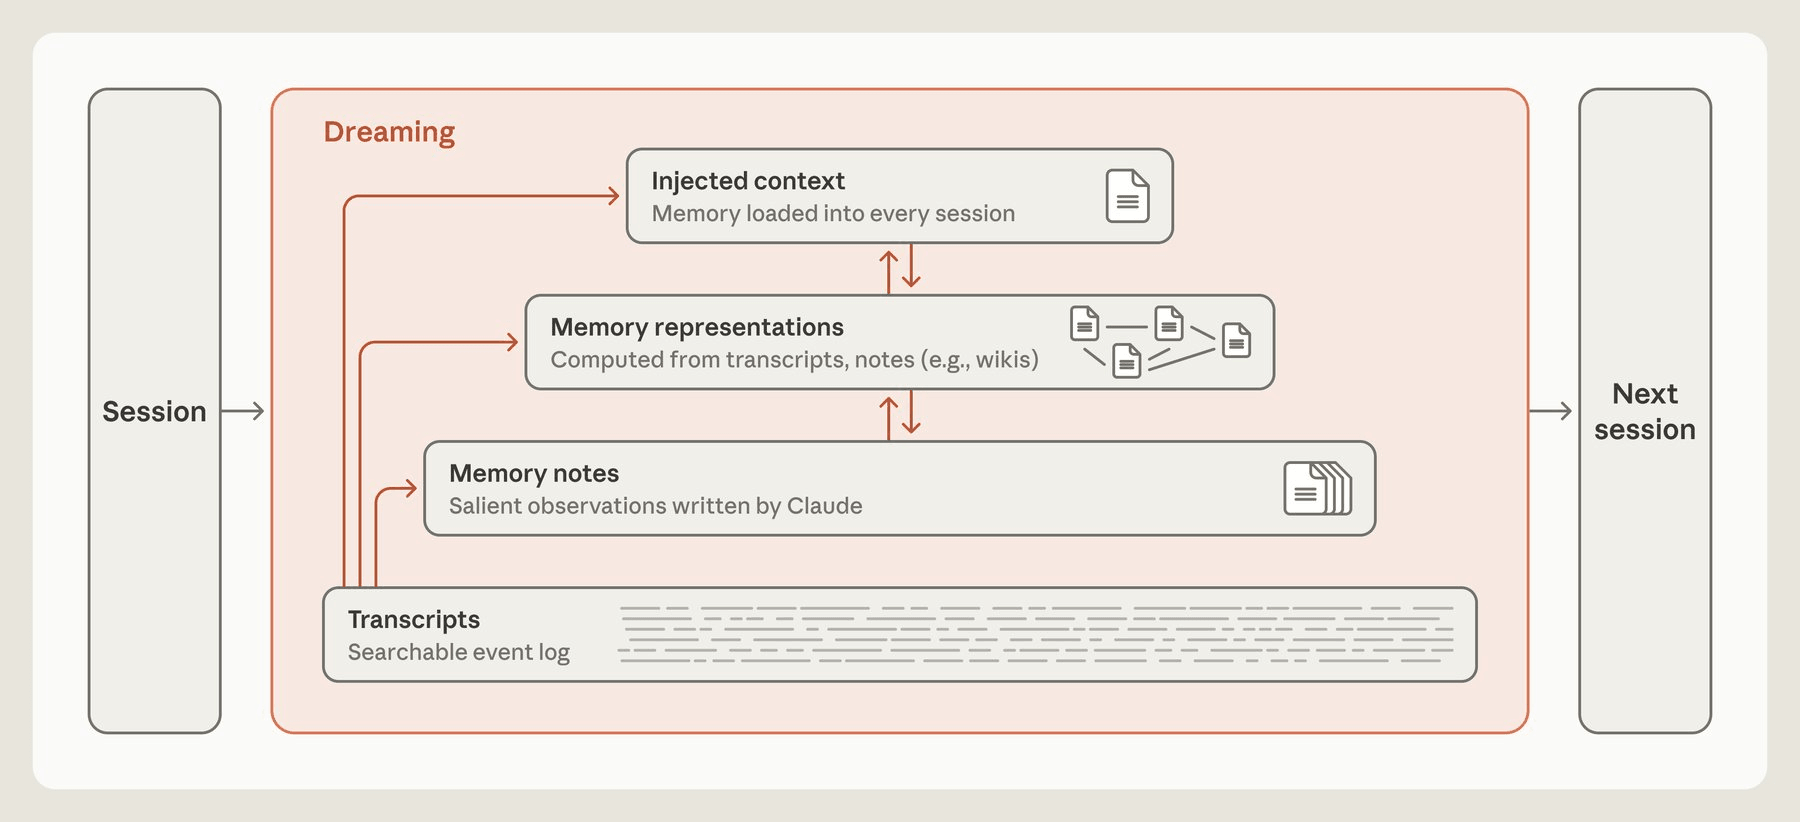
Dreaming 会在空闲期间读取先前会话的完整记录,将笔记与当时的观察、操作结果重新核对,再修正错误。原文说,这个思路建立在 Letta 和 UC Berkeley 的相关研究之上。
它做的事情很具体:检查「之前写下的结论」是否真的有记录支持。
在这次测试里,Dreaming 找到了位置错误并修正笔记。进度图覆盖 3,000 次行动,使用修正记忆的运行在第 1,935 次行动到达 Cerulean City;不用记忆和没有纠错的运行都没到达。
原文还交代了产品范围:Anthropic 在 5 月把 Dreaming 作为 Claude Managed Agents 的研究预览推出。它读取现有记忆库和最多 100 个历史会话,去除重复、过时条目,生成重新组织的记忆库,并保留原始版本。推出时仅支持 Claude Opus 4.7 和 Sonnet 4.6。
这些是原文描述的推出时状态,不能据此判断当前支持范围。
整理成 Wiki 后,为什么还需要搜索
记忆规模变大,光靠几份笔记就不够了。Anthropic 让 Claude 基于收购的软件公司 Stainless 约 350,000 份内部文档,建立带链接的 Wiki。Dreaming 持续补页面、修复缺口、去重,并处理失效链接。
Wiki 的作用,是提前把分散的信息组织起来,让后续问题少做一些临时拼接。
实验用 25 个问题评估答案满足评分条件的比例。随着整理推进,单用 Wiki 从 13% 升到 48%,Wiki 加搜索从 54% 升到 61%,单用搜索保持在 53%。配图还展示了整理 2 个会话与 128 个会话后的知识网络。
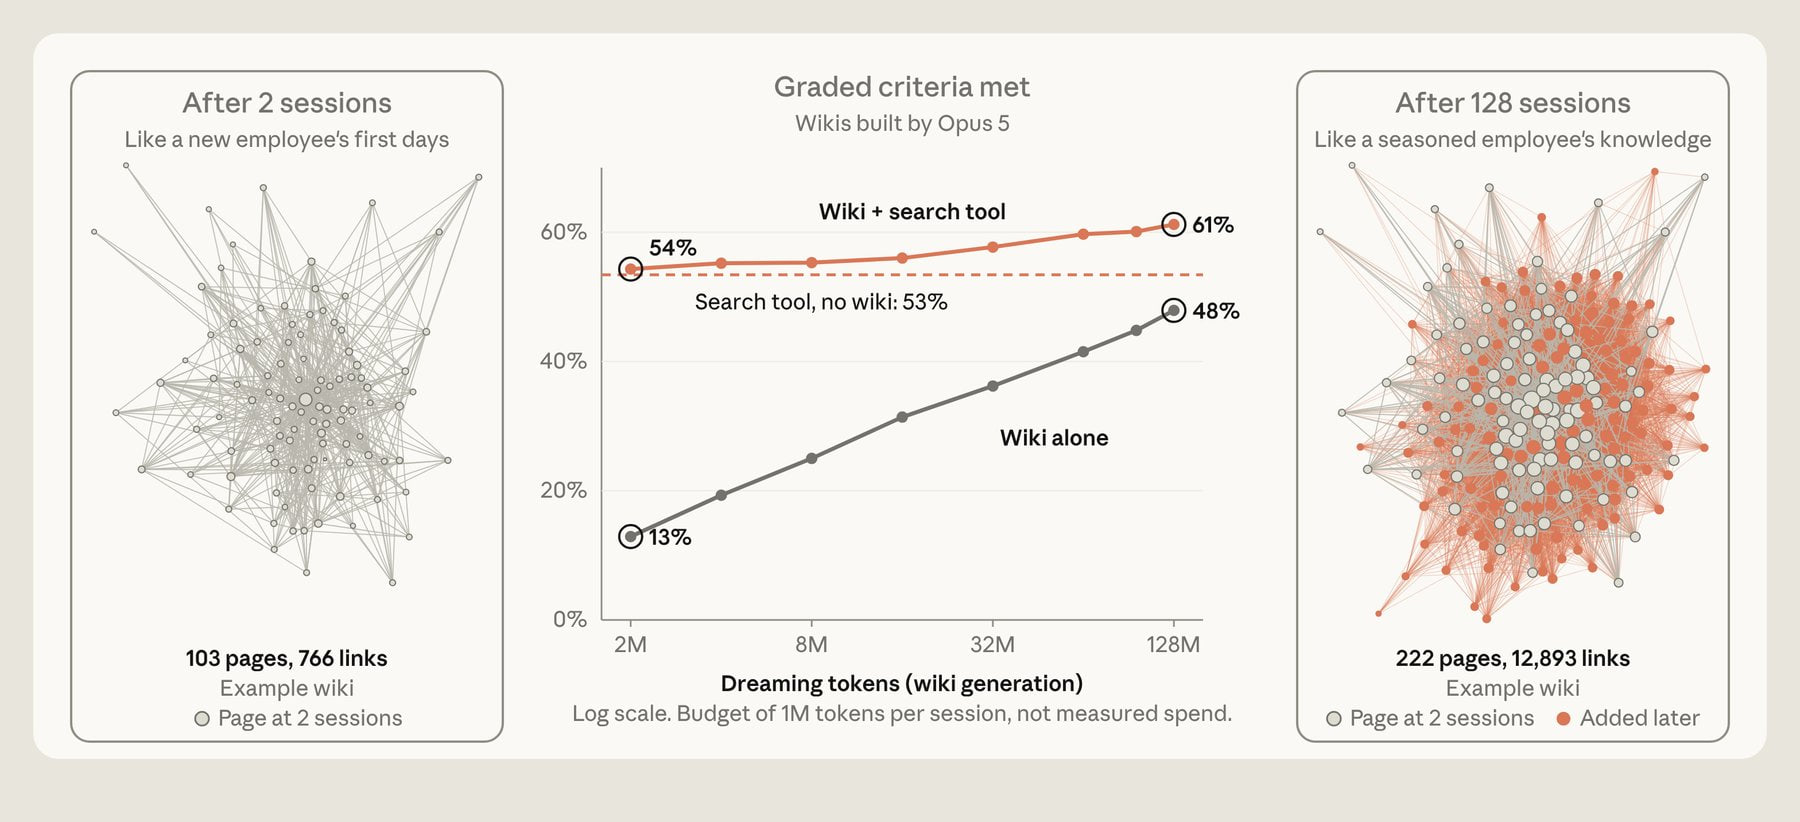
另一项法律测试中,答案散落在多份文档里的问题,使用 Wiki 得分为 87%,仅搜索为 73%。简单查找任务上,两者大致相当。还有一个案例里,Wiki 的体积甚至超过了源文档。
所以,整理知识有价值,却没有消除检索需求。原始资料负责提供细节和证据,Wiki 负责连接跨文档的关系,两者组合的结果最好。
「Dreaming」这个名字也不代表统一技术。原文提到,OpenAI 在 6 月调整的 ChatGPT 记忆也使用这一名称,通过后台维护用户资料、纠正过时信息,把时间准确率从 52.2% 提升到 75.1%。Google 和 Google DeepMind 的相关研究则利用已存结果探索替代方案,改进搜索策略,过程中不再调用模型。Google 的 WikiSkill 也将原始记录、提炼知识和具体指令分层保存。
这些工作的目标、机制和评估指标不同,不能把提升幅度放在一起排名。
我的判断
我认同这篇最实用的判断:记忆系统需要同时考虑筛选、纠错和维护,存储容量只是其中一环。尤其在 AI 编程里,未经验证的原因推测一旦写成项目事实,后面的会话就可能围着错误前提继续修改。
但证据边界要保留。全部实验都来自 Anthropic;游戏对比存在模型差异且每个模型仅一次运行,文档测试也不足以覆盖一般团队的代码库和知识库。哪些信息该留下,目前更多还是实验观察与工程经验。
成本同样没交代完整。边做任务边写笔记会打断执行,Dreaming 额外消耗计算,整理结果还存在延迟。原文没有给出足够的成本、耗时对照,无法判断普通团队多久整理一次才划算。
相比不断扩大上下文,分层记忆提供了筛选和纠错的空间;相比直接搜索,它多承担了一套知识维护工作。对于临时任务,搜索可能已经够用;对于持续数周、反复涉及跨文档关系的任务,整理记忆才更有讨论价值。
自动整理过的笔记,仍然需要能追溯到证据。
能拿来做什么
- 给长期使用的编程 Agent 准备简短项目笔记,优先保存已验证的运行方式、架构约束和排障结论。当前代码里随时可查的细节,不必再抄一遍。
- 把原始会话记录与提炼后的知识分开保存。任务完成后,再核对关键结论是否有工具输出或实际结果支持,并给推测保留明确标记。
- 面对前端组件规范、Node 服务文档等跨文档问题,可以尝试用 Wiki 整理关系,同时保留源文档搜索,再用真实任务比较效果。
- 每次会话只加载与当前任务相关的笔记。发现过时规则及时修正,避免一条错误结论进入所有后续任务。