Anthropic 称 AI 将 GPU 迁移缩至三天
Anthropic 称其内部模型 Mythos 在几乎无人干预的情况下,用三天完成 Claude 向 AMD GPU 的移植。公司表示 Claude 已运行于四类芯片平台,以降低成本和供应商依赖。
AI 深度解读
Anthropic 声称,自己的模型 Mythos 只用三天,就完成了过去需要六到十二个月的 AMD 芯片适配工作。这个案例指向一个变化:AI 如果能承担底层软件迁移,Nvidia 靠 CUDA 建立的开发生态优势,可能会受到削弱。
但「三天切换芯片」需要拆开看。原文披露的性能口径,是 Anthropic 模型在 AMD MI355X 上的提示词处理;数据来自投资者演示,尚无独立验证。对程序员来说,它更值得讨论的是:哪些迁移成本能被 AI 压低,哪些工程前提不能省。
三天完成的,到底是哪部分迁移
CUDA 的优势不只是让代码能在 Nvidia GPU 上运行,还包括围绕硬件积累的软件、工具和优化经验。换一类芯片,通常要重新适配计算内核(kernel)和推理软件栈。这里的内核,可以理解为直接承担矩阵运算等底层计算任务的程序。
按 Anthropic 的说法,过去启用新芯片平台,需要数十名工程师忙上数月。这次首次使用 AMD GPU 时,他们让自家的前沿模型 Mythos 编写或迁移了接近 100% 的内核,几乎没有人工干预,三天后 Claude 就能运行。
接近 100% 的内核由 AI 完成,不等于整个芯片平台的全部工程都由 AI 完成。
原文图表给出的范围更具体:在 AMD MI355X GPU 上,对某个 Anthropic 模型进行提示词处理,约三天达到可用性能水平,曲线标示接近 100%;传统工程路径则需要六到十二个月。
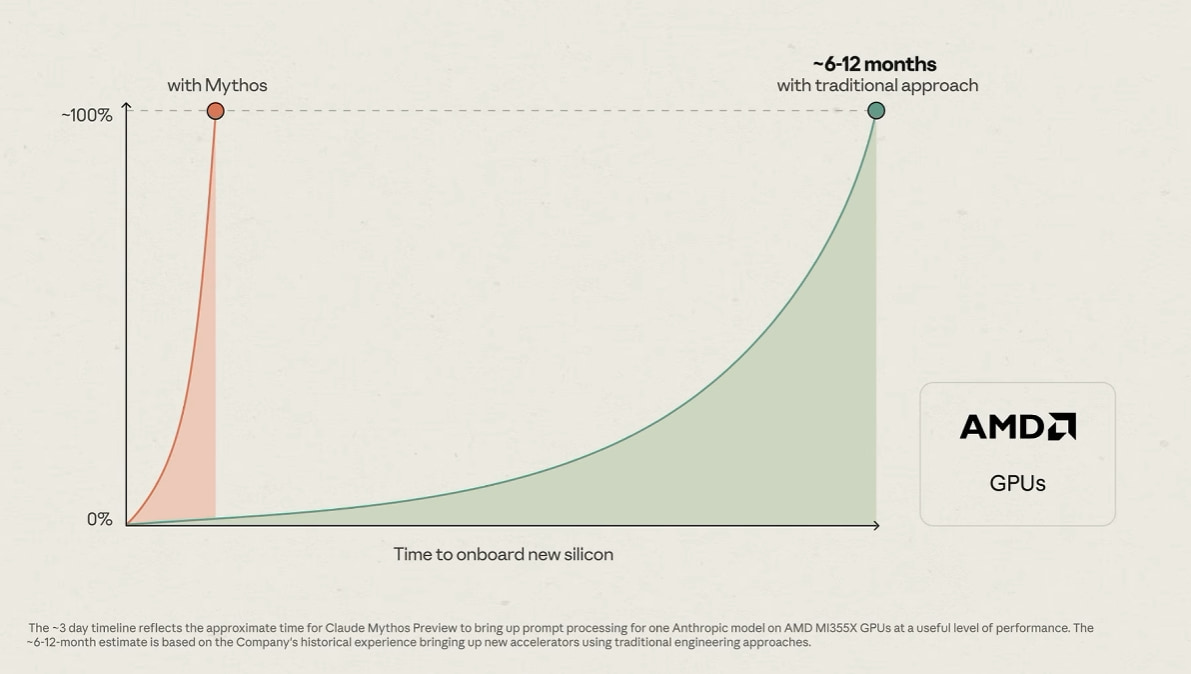
提示词处理只是模型服务的一部分。原文没有交代完整的训练迁移、逐 token 生成、长时间运行稳定性,也没解释图中 100% 的性能基准如何定义。因此,「三天」可以作为一次适配成果来理解,还不足以证明所有 Claude 工作负载都能三天迁走。
另外,六到十二个月是否来自相同任务、相同验收标准下的对照实验,原文也没说清。
能切换四种芯片,靠的不只是一次模型调用
Anthropic 联合创始人、Chief Compute Officer Tom Brown 表示,公司已经能在四大芯片家族上训练和运行 Claude:AWS Trainium、Google TPU、Nvidia GPU 和 AMD GPU。
他们把不同供应商、架构、地点的算力视为一个可互换的资源池,分配给研究、模型开发、客户需求和内部 Claude 使用。
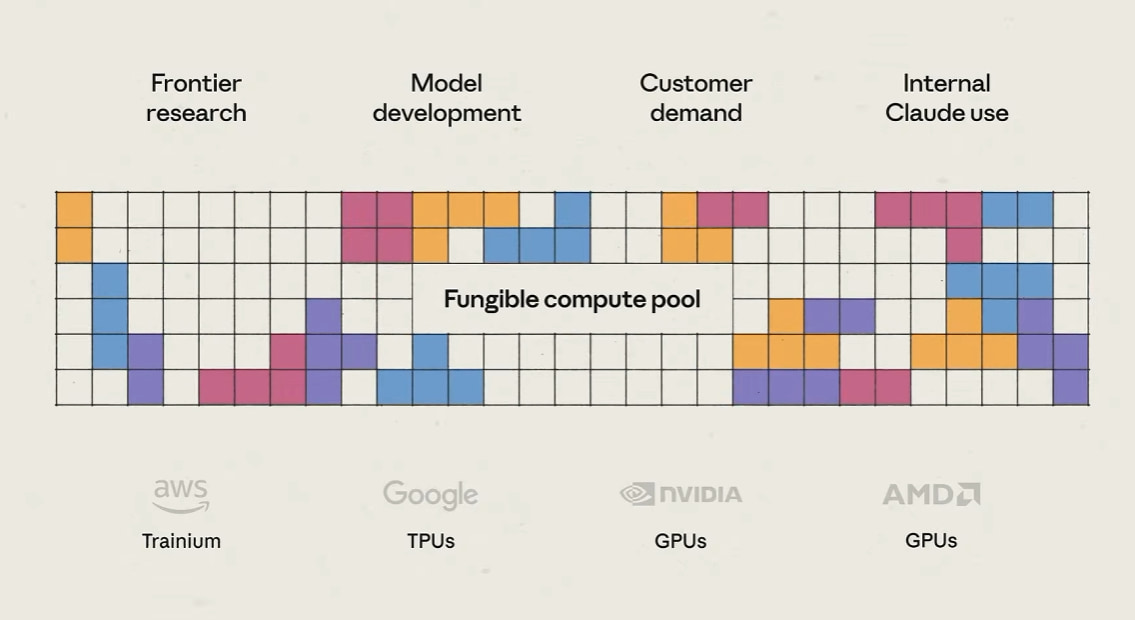
这里的「可互换」,更适合从资源调度层面理解:同一类业务需求,可以有多个硬件去处。它不代表同一份底层代码无需修改,就能在所有芯片上运行。
Brown 也承认,每种芯片都需要专门的软件和推理栈,成本高、耗时长。Anthropic 很早就押注多芯片策略,并已持续投入多年。
所以,这个故事里有两个条件:AI 降低了此次适配的工程负担;团队此前已经建立了支持多种硬件的能力。不能把多年积累从结果里扣掉,只留下「让模型干三天」。
多芯片的商业价值也很直接。算力供应紧张时,公司可以按供货和性价比选供应商,再根据训练、推理的不同需求分配任务。原文还提到 Nvidia 超过 70% 的利润率,不过没有明确具体财务口径,不宜据此推算换芯后的降价空间。
降低算力成本,还要靠算法和机房
Anthropic 把另一条路线称为 compute multipliers,即通过研究突破,让同样的物理算力产出更多有效计算。公司认为,这些改进可以相互叠加。
但原文没有列出具体技术、收益数字和对照实验。现阶段,它更像一套研究方向的表述,不能直接当成已经兑现的效率提升。
更远的设想是让 Claude 自己发现新的 compute multipliers,形成递归自我改进:模型改进计算方法,改进后的计算能力再帮助模型继续研究。原文明确说,这个概念尚未得到证明。
与此同时,Anthropic 通过 Anthropic Direct 租赁芯片,在专门建设的数据中心运营,希望降低总拥有成本。它改变的是算力采购和运营方式,实际能省多少,原文没有提供结果。
多芯片也不等于与 Nvidia 切断关系。双方仍有深度资本联系:
- 2025 年 11 月,在与 Microsoft 的 450 亿美元交易中,Nvidia 承诺向 Anthropic 投资最多 100 亿美元。
- 根据 2026 年 11 月 10 日提交给 SEC 的 S-1/A,Nvidia 还参与了一项总额 260 亿美元的附条件私募,七家科技公司按 IPO 价格认购。
- AMD 在 2026 年 7 月宣布最多投资 50 亿美元;Anthropic 则计划在 Helios 机架级系统中部署最多两吉瓦的 AMD Instinct MI455X,首个一吉瓦阶段于 2027 年上半年启动。
这里必须分清:三天适配案例用的是 MI355X,未来部署计划用的是 MI455X。
我的判断
我认同这篇文章提出的方向:如果 AI 能可靠地编写和迁移底层内核,CUDA 生态带来的迁移成本就可能下降。硬件竞争也会因此多一个变量。
但「CUDA 护城河已经被突破」仍然下结论过早。最关键的数据来自投资者演示,尚无独立验证;「每美元算力产出高于其他前沿实验室」同样缺少可比较的证据。
和人工迁移相比,这个案例展示了 AI 承担大量具体实现工作的可能性,却没有给出足够细的对照条件。和购买云算力相比,自租芯片、自营机房能否更省,也取决于规模、利用率和运维成本,原文未展开。
对普通前端和全栈团队,最有参考价值的不是立刻搭建多芯片资源池,而是重新评估迁移任务:过去因人工成本过高而搁置的工作,如今可能值得做一次范围明确的验证。
能拿来做什么
- 如果你维护 Node 模型服务,可以把提示词处理耗时、生成速度和服务稳定性分别验收,避免用单项性能结果代表整个服务已经完成迁移。
- 如果团队需要切换推理硬件,可以先挑一个边界清楚的算子或内核,让 AI 尝试适配,再检查数值正确性和实际性能,用局部结果决定是否扩大范围。
- 评估 AI 迁移案例时,应同时记录已有基础设施、人工参与和验收范围。把这些前提写清楚,才能判断「三天」对自己的项目有没有参考价值。