Claude Fable 5.1 的性能与缓存成本分析
文章称 Anthropic 于 2026 年 9 月发布 Claude Fable 5.1,标价维持前代水平,缓存读取价格降低 75%,代理科学任务基准得分超过前代两倍。摘要强调不同基准的增益并不一致,部分结论仍需独立验证。
AI 深度解读
Claude Fable 5.1 值不值得换,不能只看榜单第一。按原文提供的数据,它在长任务、终端操作和多步工具调用上进步明显,但日常 IDE 编程的领先幅度有限;缓存读取降价 75%,也不代表最终账单一定下降。
对前端和全栈开发者,真正需要判断的是:你的瓶颈在复杂任务做不出来,还是普通任务做得太贵?这篇解读围绕能力、成本和迁移风险展开。以下产品信息与测试结果均来自所给原文,未作外部核验。
长任务进步很大,日常写代码未必值得加钱
原文称,Anthropic 于 2026 年 9 月 1 日发布 Claude Fable 5.1,接替 Fable 5。规格延续 1M tokens 上下文、128K tokens 最大输出;自适应思考始终开启,通过 effort 控制深度,默认 high。知识截止时间更新至 2026 年 6 月,API ID 为 claude-fable-5-1。
它的优势集中在需要持续操作、观察结果并修正路线的任务上。
Terminal-Bench-Science 0.1 衡量模型在终端中自主完成科学研究任务的能力。Fable 5.1 得分 52.6%,Fable 5 为 24.7%,Opus 5 为 29.0%,GPT-5.6 Sol 为 22.4%。各模型标准误差为 ±3.5 至 4.5 个百分点,新版领先约 23 至 30 个百分点,差距明显大于这一区间。
工程任务也有提升。测试多步编程与调试的 Terminal-Bench 4.0 上,新版达到 55.8%,高于 Fable 5 的 42.0%,但只领先 Opus 5 的 52.3% 共 3.5 个百分点。业务自动化测试 AutomationBench 上,新版为 31.4%,Fable 5 和 GPT-5.6 Sol 分别为 17.1%、19.6%。
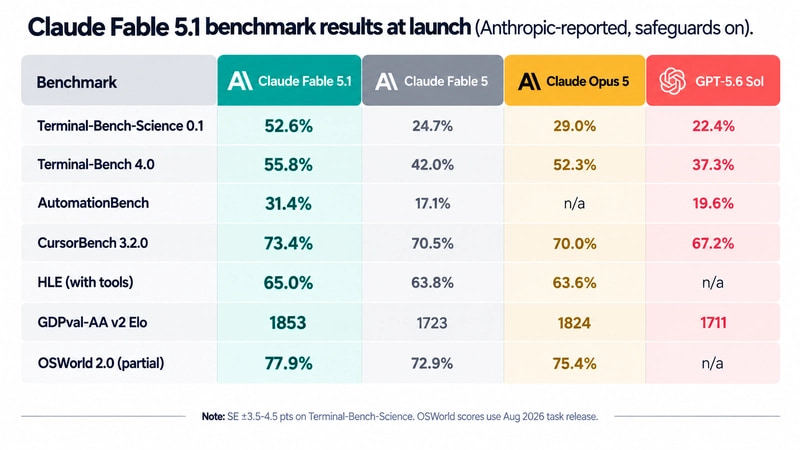
到了日常 IDE 编程,差距收窄了。CursorBench 3.2.0 中,新版为 73.4%,Fable 5 为 70.5%,Opus 5 为 70.0%。相对 Opus 5,只多出 3.4 个百分点,原文给出的每 token 价格却是两倍。
知识工作同样需要区分尺度。GDPval-AA v2 的 Elo 分数分别为新版 1853、Opus 5 1824、Fable 5 1723、GPT-5.6 Sol 1711。Elo 是相对比较分数,不能当成任务成功率。HLE 中,新版无工具与有工具成绩为 60.9%、65.0%,Opus 5 为 56.6%、63.6%,使用工具后仅差 1.4 个百分点。
这些结果支持优先评估复杂长任务,尚不足以支持日常编码全面换模。
缓存便宜了,为什么单次任务仍可能更贵
标准输入、输出价格没有变,仍为每百万 tokens $10/$50。变化最大的是缓存读取,从 $1.00 降至 $0.25,下降 75%,原来的预算可以读取四倍缓存内容。
缓存写入仍要付费:5 分钟缓存每百万 tokens $12.50,1 小时缓存 $20;Batch API 的输入、输出价格为 $5/$25。
缓存适合反复读取相同上下文的 Agent,例如每轮都要带上系统指令、工具定义和代码库内容。原文举例,一个会话内反复读取 500K tokens 的代码库数百次,读取单价下降会持续累积收益。
但别把缓存读取降幅直接套到总账单。Anthropic 估计,典型工作负载约省 25%,高度依赖 Agent 的工作负载约省 45%。这是厂商估计,前提是缓存命中足够多。
原文引用的 Artificial Analysis 测试提供了另一面:在最大 effort 下,新版输出 tokens 约为 Fable 5 的 1.7 倍,每个 Intelligence Index 任务的成本反而高约 20%。新版单任务约 $3.76,Opus 5 约 $2.34。
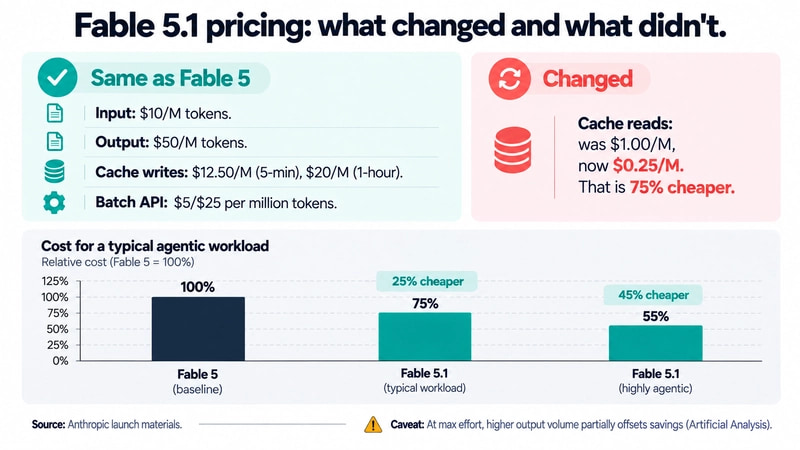
这里有两组不同的比较:高约 20% 是相对 Fable 5,$3.76 对 $2.34 是相对 Opus 5,不能混用。默认 high 与最大 effort 的结果也不能直接画等号。
决定账单的是每个成功任务消耗多少输入、缓存和输出,而不是某一项单价。
换模型之前,先检查接口和成绩的适用条件
迁移最直接的风险有两个。
首先,强制工具调用发生变化。原文称,tool_choice 设为 any 或指定工具时,新版会返回 400。如果工作流靠它保证某个工具必定执行,只替换模型 ID 就可能让请求失败。原文没有提供替代写法,不能自行假定换成其他模式就能保持原来的保证。
其次,扩展思考块存在单向兼容:Fable 5.1 能读取旧模型的思考块,旧模型不能读取新版的。修改早期对话轮次也会使思考块失效;该规则对 2026 年 8 月 31 日及之后创建的 API 账户严格执行。多模型接力和历史会话回放都需要检查。
成绩也有使用边界。发布表包含九项基准,全部由 Anthropic 在生产安全配置开启的条件下运行。
例如 OSWorld 2.0 使用基准作者 2026 年 8 月发布的任务集,不能直接与旧版 OSWorld 成绩比较。新版部分完成、严格完成成绩为 77.9%、41.7%,Opus 5 为 75.4%、39.6%;表中没有 GPT-5.6 Sol 成绩。安全机制介入的任务,两代 Fable 都记零分。
原文还称,Mythos 5.1 与 Fable 5.1 使用相同权重,但安全配置和准入不同,仅面向通过 Cyber Verification Program 或 Life Sciences Verification Program 审核的组织。Mythos 5.1 的 Terminal-Bench 4.0 为 60.9%,高于 Fable 5.1 的 55.8%。这支持安全配置会影响可用能力,但不能据此推断所有任务都有相同损失。
新版网络安全过滤误报据称减少 60%,基础生物和医学无害问题的过滤触发减少 85%。它们是特定范围内的报告结果,不能扩展成整体拒答率下降同样比例。
我的判断
我认同原文按任务类型选模型的方向,但需要把证据分层。
独立结果支持新版整体能力更强:Artificial Analysis 的 Intelligence Index 给出 66 分,Opus 5 为 63,GPT-5.6 Sol 为 61;原文另列 ARC-AGI-1 的 97.5%,以及 Vals Index 第一。这些结果没有独立复现发布表中的每一个分差。
真实案例的证据更有限。Millennium 据称用新版定位了困扰四至五年的崩溃,根因在外部供应商库中;Adaptyv Bio 的三个蛋白设计目标据称获得接近 50% 的结合蛋白命中率。前者是厂商挑选的单例,后者仍待独立检验,作者没有提供足够对照来证明一般团队也能复现。
还有一个容易误判的地方:安全机制让任务记零,在能力研究中可能低估模型上限;但对生产应用而言,请求被拒绝就是实际结果。团队应评估自己能调用到的配置。
原文转述的厂商建议也偏克制:大多数工作先用 Opus 5,较高 effort 仍达不到要求,再评估 Fable 5.1。比起统一升级,保留默认模型、为少数困难任务设置升级路径,更符合现有证据。具体能省多少、成功率能涨多少,仍需自己的数据回答。
能拿来做什么
- 用已有失败案例评估升级价值,优先选择跨文件排错、复杂故障定位和多轮工具任务;前端日常补全、组件修改则单独统计,避免平均分掩盖差异。
- 在相同任务和明确的
effort设置下,对比 Opus 5 与 Fable 5.1,记录完成率、耗时、输出 tokens、缓存命中量及每个成功任务成本。 - 在 Node Agent 的迁移审查中,检查
tool_choice、400处理、思考块传递和历史消息编辑;原文未说明的替代接口行为,需要通过实际请求验证。 - 对重复携带大型代码上下文的流程,先确认缓存是否命中、有效期是否合适,再计算 $0.25/M 的收益,避免把读取降价直接写成整体预算降幅。