Cloudflare开放两款信息抽取模型权重
Clairic 结束预览,Clairic-flash 加入 Workers AI。Cloudflare 同时开放了两款信息抽取模型的权重。
AI 深度解读
Cloudflare 更新了文档抽取模型 Clairic,并把更轻的 9B 版本作为 Clairic-flash 单独发布。两个模型都能在 Workers AI 上调用,也都在 Hugging Face 开放了完整权重。原先接入预览端点的应用会切到 27B 的新版 Clairic,API schema 沿用预览版。
对做前端和全栈的同学,这次更新最实用的是,一张跨页 PDF 里的供应商、商品明细和总额,可以在一次请求里按字段取出来。但选哪个模型、能不能省掉人工复核,还得看内部评测测了什么,以及四页上限和促销结束后的价格。
一次请求能从票据里拿回什么
假设你要做一个报销录入页,用户上传两页 PDF,供应商和总额在首页,明细在第二页。Clairic 可以在一次请求里取齐这些字段,并按行返回明细,把同一件商品的描述、数量和价格放在一起。应用可以直接拿这些行填表,省去从一段文本里重新配对的工夫。新版也改善了表格、列表和日期的抽取,以及答案与原文的对应。每次请求最多可以带 四张图片或四页 PDF,混传时合计也是四个。
沿用预览版的类型化 API 仍会返回置信分数、字符跨度和概率。字符跨度可以帮助应用定位一段答案在源文本里的位置。如果想在 PDF 上画高亮,还需要确认手里的文本位置能否映射到页面坐标,原文没交代这层映射。置信分数则可以用来决定哪些字段优先进入人工复核。
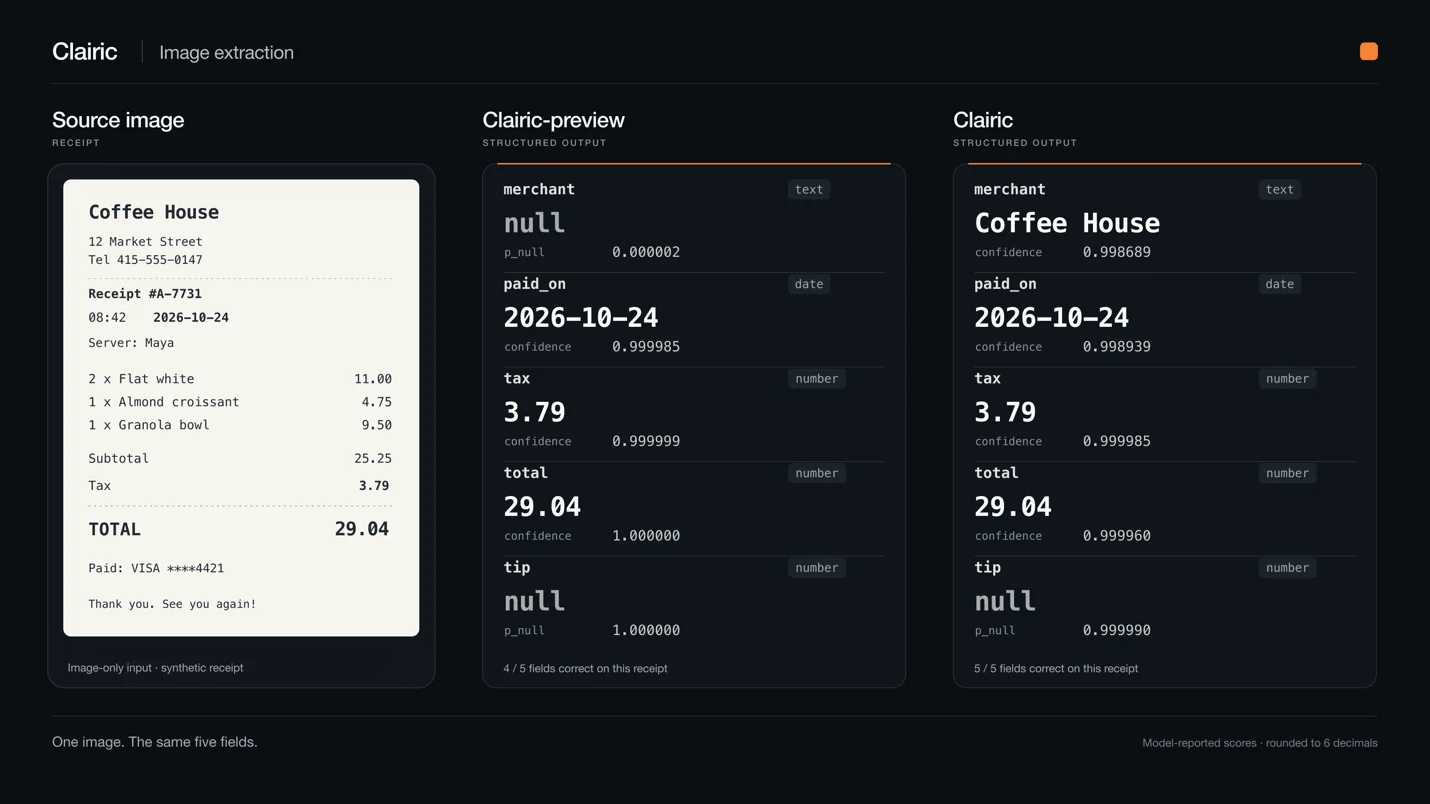
作者用一张合成咖啡店小票做了对照。Clairic-preview 在商户名字段返回 null,新版读出了 Coffee House,五个字段全部答对。这张图说明了新版补回了哪个字段,样例本身只覆盖这一张票。
为什么逐个生成 token,还能把响应压到一秒内
普通文本和数字字段,预览版用一次前向计算给出结果。新版改用并行槽位自回归生成(parallel slot autoregressive generation)。每个字段占一个槽位,根据自己已经生成的 token 决定下一个 token,遇到自己的结束标记就停。单个字段内部要一步步写,但商户名、金额、日期等字段可以在同一个推理批次里一起往前走。作者报告,这个改动提高了文本和图片抽取的准确率,代价是少量额外延迟。
估算、预测、时长、日期推算和显式算术,则交给专门训练的输出头处理。接入时可以据此区分两类字段:发票上印着的日期是读出来的,按账期推算的到期日是算出来的。两种结果都能填入表单,但业务校验的依据不同。
延迟是作者实测过的。他们在自托管服务器上计时,测的是包含全部请求字段的完整 HTTP 响应。文章报告响应可在一秒内返回,并列出 Clairic-flash 的 p50、p95 和「费用审计开发」场景。给出的正文没有展开具体分位值、硬件或并发条件。你的上传耗时、PDF 页数和字段数量,都应该算进实际业务的等待时间。
旧端点会切到 27B,账单什么时候变
原预览端点 @cf/cloudflare/clairic 托管的是 9B 模型。Cloudflare 把更新后的 9B 版本放到 @cf/cloudflare/clairic-flash,原端点则原地切换到 27B 的新版 Clairic。现有调用可以沿用同一套 API schema,但端点背后的模型变了,关键字段仍有必要用旧样本回归一遍。两个版本的完整权重都已在 Hugging Face 开放。
按 Cloudflare 公告,促销期间两款模型都是每百万输入 token 0.10 美元。2026 年 12 月 1 日促销结束后,27B Clairic 恢复到每百万输入 token 0.24 美元,9B Clairic-flash 维持 0.10 美元。两款都只按输入 token 收费,输出 token 免费。同一批请求如果输入 token 数相同,促销结束后走 27B 的模型费用是走 9B 的 2.4 倍。
我的判断
这次发布最有说服力的是接口贴近业务。跨页取字段、保持明细行的对应关系、给人工复核保留定位信息,都是上传文档后真正要处理的问题。固定字段的录入流程里,专用模型值得和现有的 OCR 加规则、通用 LLM 加结构化输出放在一起测。版式固定、字段少时,OCR 加规则方便查错。来源杂、表格经常变时,再看专用模型能多覆盖多少样本。至于它和已经在用的通用 LLM 相比能省多少,原文没有给出同一工作负载下的完整成本和延迟对照,普遍更快更便宜的判断仍是经验之谈。
评测有实测成分,证据也有边界。作者列出了 96 次新文本字段请求、36 次混合输入请求的内部评测 mchen、139 种跟踪客户断言的请求形态,以及文本和图片形式的合成小票。他们也用内部评测比较了 Liquid AI 的 D1.2 加 Apple Vision OCR,以及 Scaledown 的 Extract。作者报告内部基准的错误数从 207 降到 0,并说明该基准覆盖文本和图片。原文没有给出这项统计对应的样本总量和错误口径,作者也明确说评测是自报的,当时没有公开的抽取基准。真实业务里,我会单独看关键金额填错的比例和需要人工补录的比例,避免被一个汇总结果带偏。
能拿来做什么
- 用 Node 在服务端接住报销单或发票上传,按供应商、明细行、总额请求抽取。前端保留原文件预览,让用户在同一页核对缺失或低置信字段。
- 用相同的一批脱敏票据跑两个端点,分别记录缺字段、填错值、明细行错配和完整 HTTP 响应的 p50、p95。把扫描件和跨页明细也放进去,再按业务能接受的错误率选模型。
- 预览版应用既要回归原端点切换 27B 后的结果,也要按 2026 年 12 月 1 日之后的单价重算账单。如果 9B 在关键字段上达标,就能把对价格敏感的批量任务迁过去。
- 在上传入口把图片和 PDF 页数合并计数。超过四页时让用户选页,或分批抽取并在服务端核对明细与总额,避免把多次返回直接当成一张完整票据。