Qwen4-Max 发布,主打低成本旗舰能力
阿里发布 Qwen4-Max,总参数量为 2.4 万亿,每个 token 激活约 710 亿参数,并以混合架构降低长上下文成本。据报道,其 Artificial Analysis 智能指数略低于 Kimi K3.1 Pro,较小版本计划开源。
AI 深度解读
Qwen4-Max 这次最值得关注的,是它试图把长任务的能力提升和成本下降一起交付:上下文达到 100 万 token,单次任务消耗的 token 更少,还允许用户在 Agent 执行途中查看成果、修改方向。对程序员来说,这比单看参数规模更有参考价值。
但「更便宜」不等于「编程最强」。原文给出的第三方结果显示,它在不同编码测试中的位置差异明显。读这次发布,要把架构改进、任务账单和实际交付能力分开看。
长上下文为什么能更便宜
据 Qwen 团队介绍,Qwen4-Max 采用混合专家架构(MoE),总参数量为 2.4 万亿,每个 token 激活 710 亿参数,支持原生图像处理。上一代 Qwen3.8-Max 同样是 2.4 万亿参数,但每个 token 激活 950 亿。
总参数相同,不代表每次生成都花同样多的计算量。
新架构按三层 Gated DeltaNet 配一层 Qwen Sparse Attention 的方式组合。前三层把历史上下文压缩成状态,第四层再选择重要部分处理。可以把它理解为:先持续整理已有信息,再有选择地回看原文,减少长输入带来的计算负担。
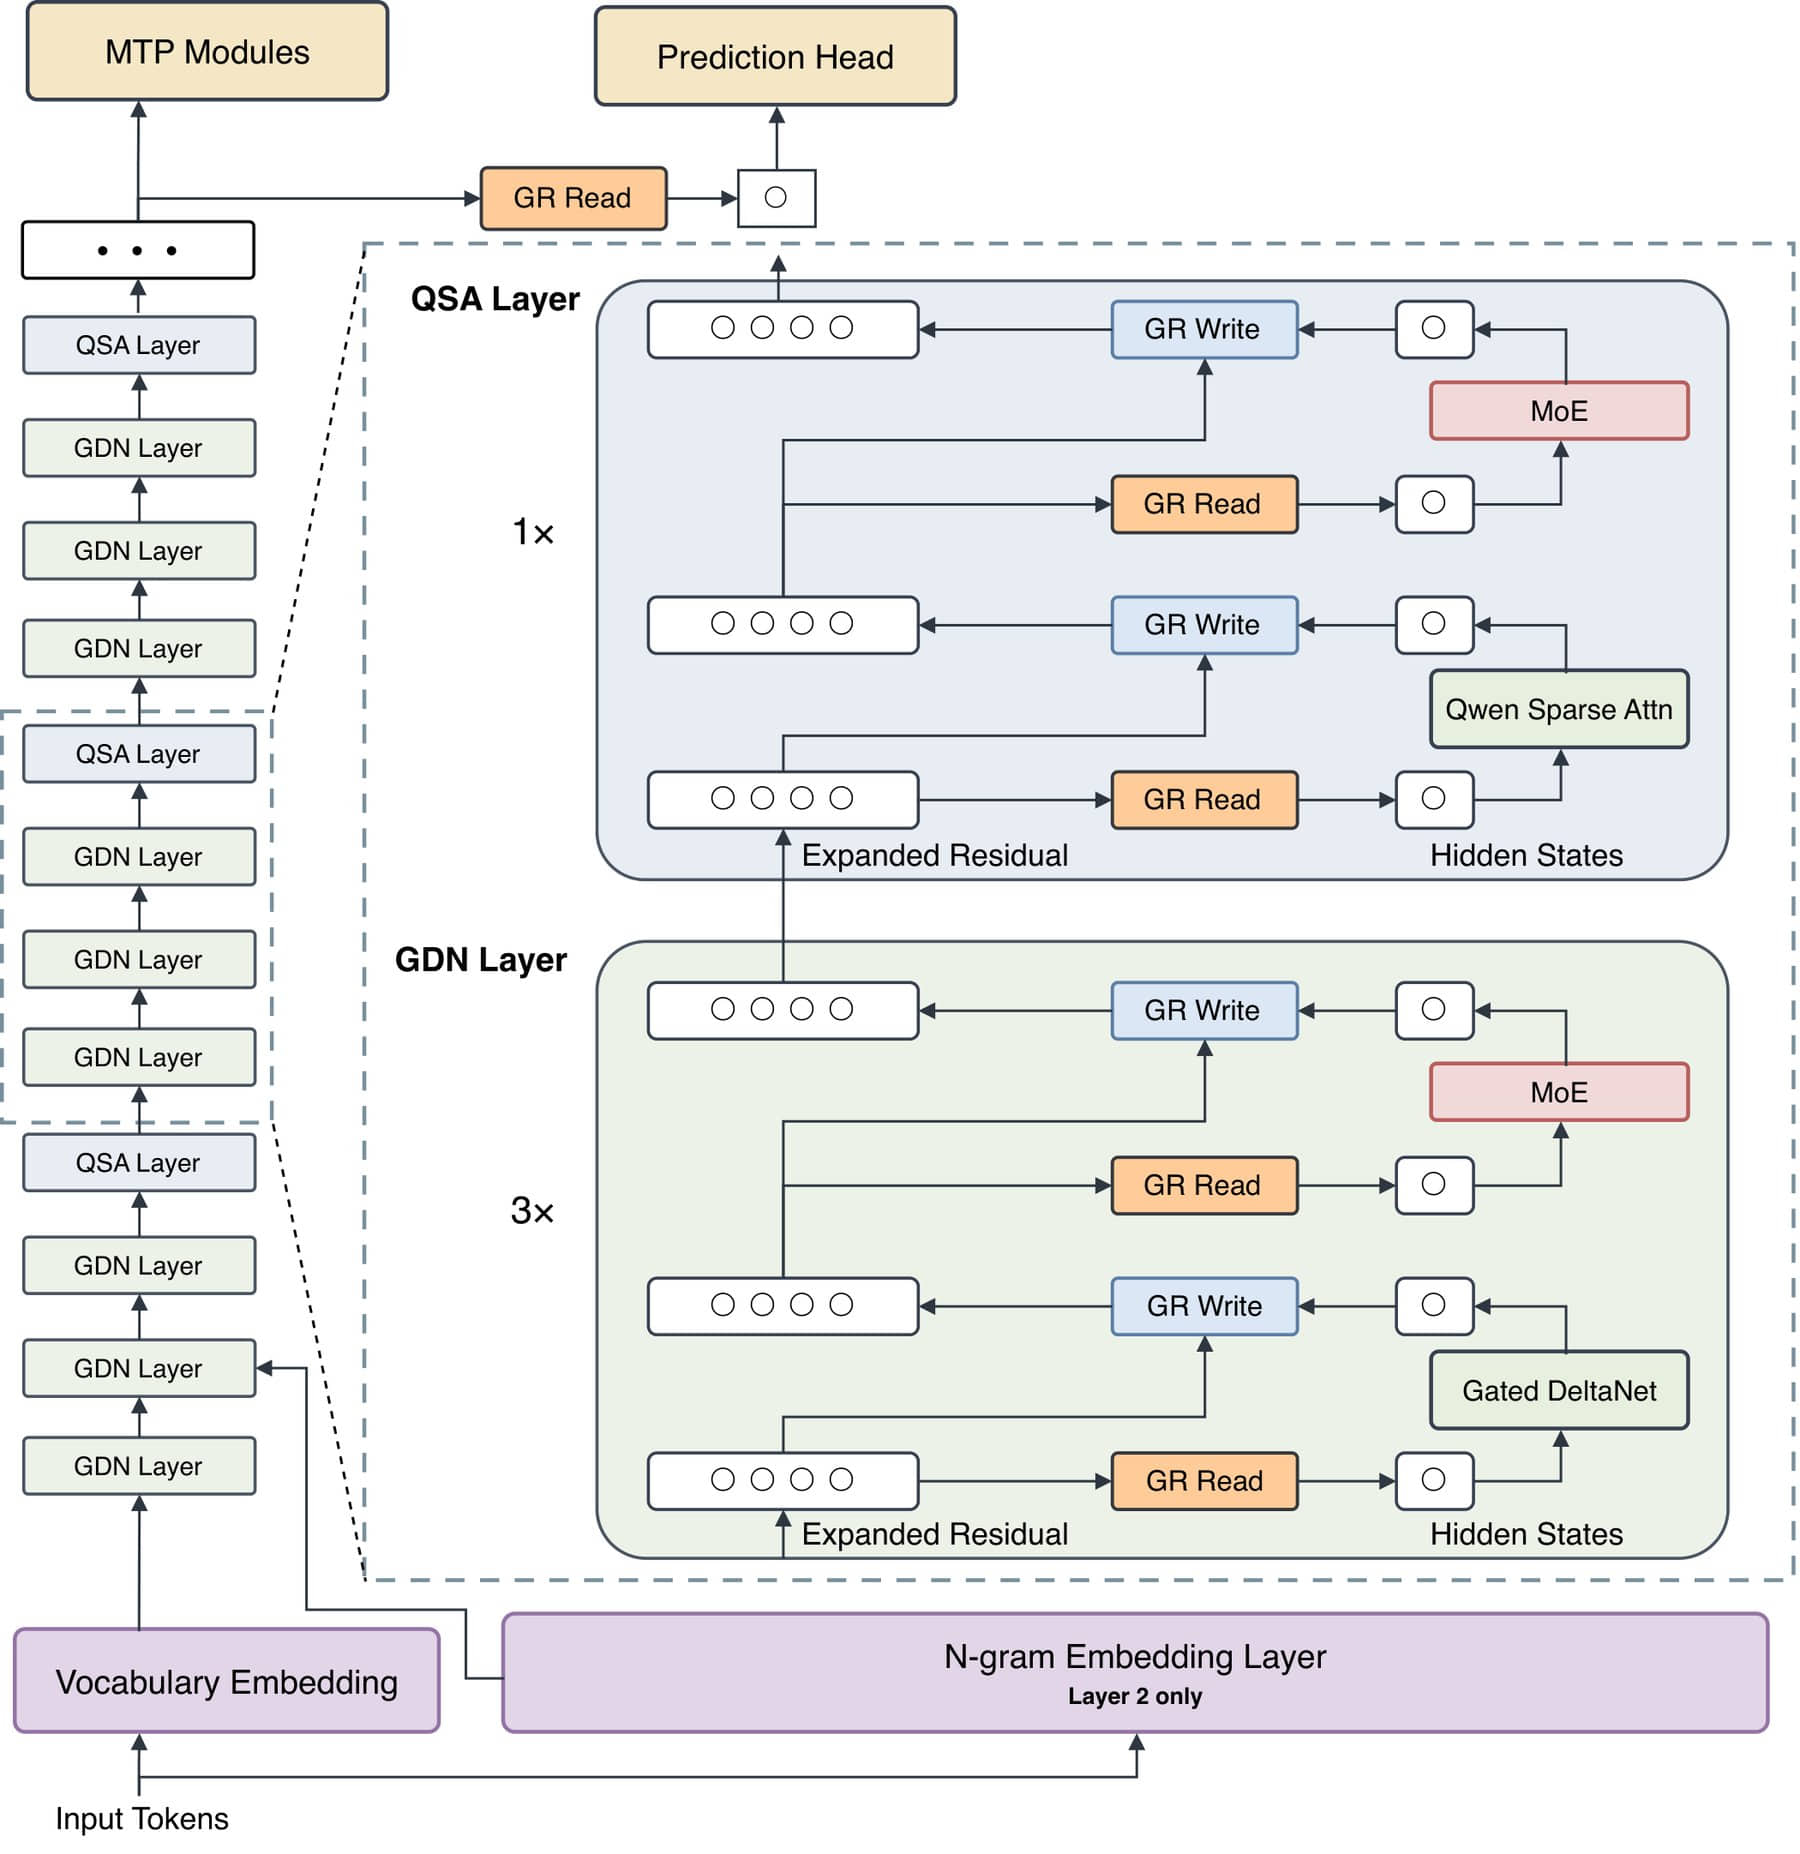
此外,层间增加了四条并行连接,通过动态门控调节信息流;一个 3280 亿参数的 N-gram embedding 层,把常见 token 序列作为可复用的组合提供给模型。阿里称,整个预训练过程损失持续下降,没有突然尖峰。
内部测试采用 bits per byte 衡量知识、代码、问答和 STEM 四类表现,数值越低越好。Qwen4-Max-Base 在五个受测检查点中均为最佳,相对 Qwen3.8-Max-Base 改善 5% 至 13%,同时每个 token 激活的参数减少 25%。
这些结果支持「架构效率有所改善」,但还不能直接推出业务代码写得更可靠。基础模型的预测指标、训练稳定性和应用层交付质量,回答的是不同问题。
单价下降之外,任务账单还省在哪里
真正该比较的是完成同类任务的总费用。
阿里自建的 Work360 覆盖 721 个专业领域。按其公布的数据,Qwen4-Max 完成相同任务少用约四分之一至三分之一的 token,平均任务成本从 $4.43 降至 $1.67,下降 62%;得分则从 47.74 升至 52.69。在 Terminal-Bench 4.0 上,token 用量接近减半。
第三方 Artificial Analysis 也给出了成本改善的证据。在 Intelligence Index v5.0.1 中,Qwen4-Max 最高推理档得分为 43,较前代增加 9 分;每项任务成本从 $10.02 降至 $3.27。输出 token 从约 171,000 降到 105,000,加上 token 单价下降 25%、缓存命中价格下降 70%,共同拉低了账单。
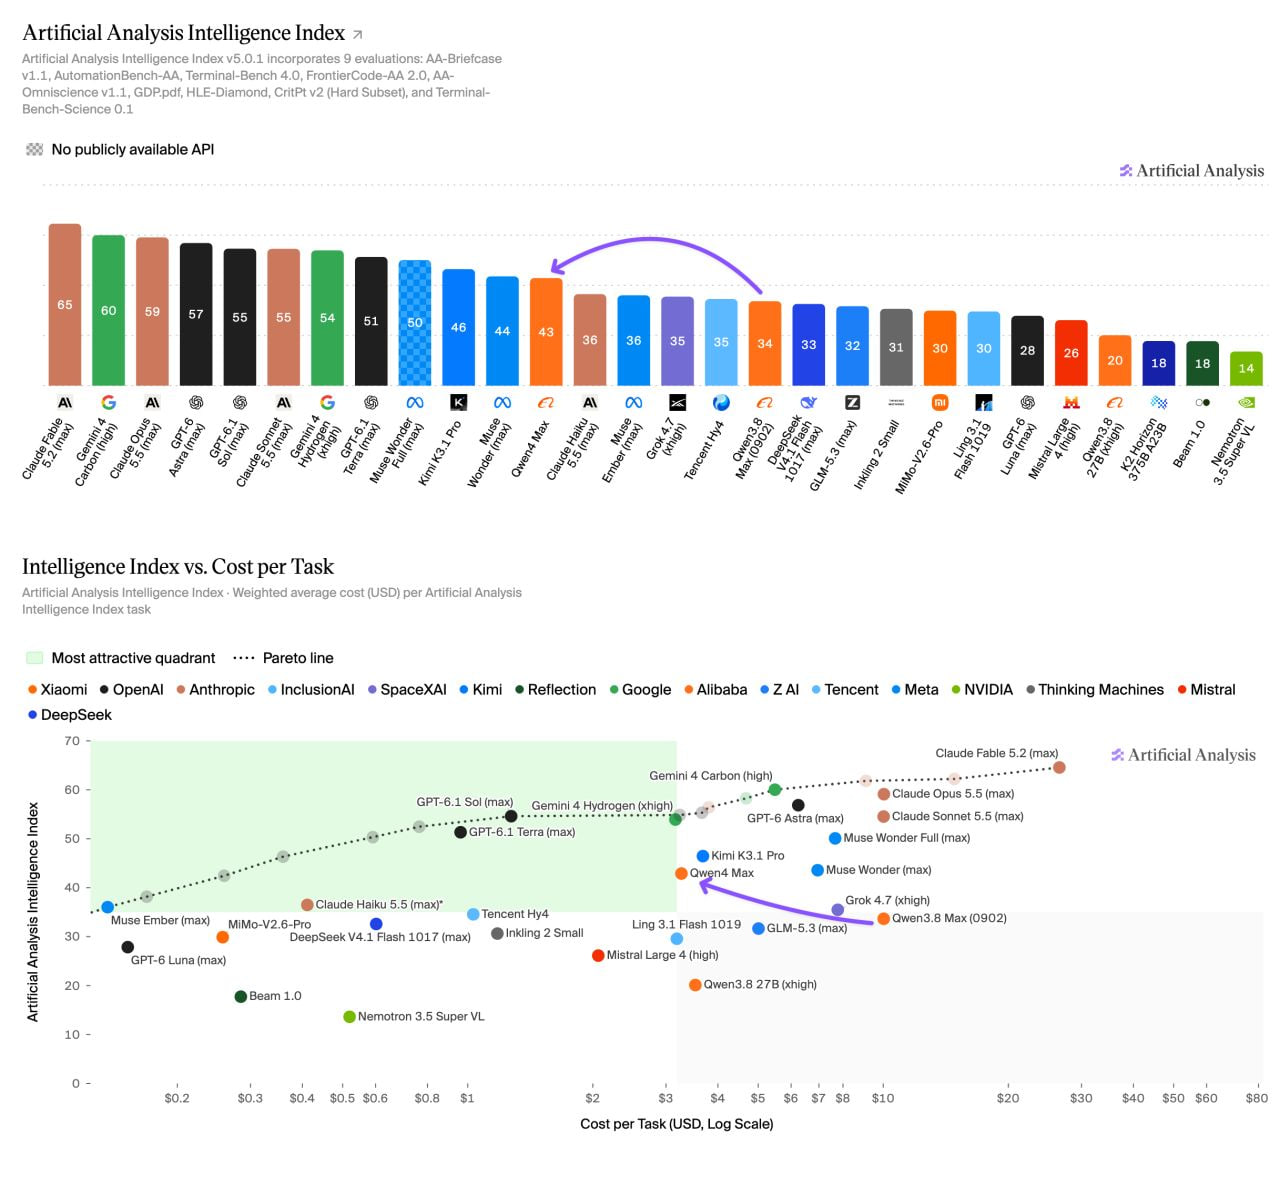
不过,原文开头的「第二名」容易让人误读。结合后文,应理解为中国模型中的第二名:Kimi K3.1 Pro 为 46 分,Qwen4-Max 为 43 分;图中的 Claude Fable 5.2 则达到 65 分,并非所有模型里只差一名。
具体到编程,结果也没有形成全面领先:
- Terminal-Bench 4.0 上,Qwen4-Max 为 48%,Kimi K3.1 Pro 为 67%。
- FrontierCode 2.0 上,Qwen4-Max 与 Kimi 均为 26%,Tencent Hy4 为 31%。
- 长程 Agent 测试 Agents' Last Exam v1.1 上,Qwen4-Max 以 46.7 分领先所列对比模型,但 Humanity's Last Exam 落后于 Opus 5.5 和 GPT 模型。
价格对照同样有取舍。Kimi K3.1 Pro 每项任务为 $3.68,Qwen4-Max 便宜约 11%;Tencent Hy4 只需 $1.03,但指数低 8 分。
阿里自有 API 的报价是每百万输入 token $1.50、每百万输出 token $4.50,缓存命中价格为 $0.075。它适合进入候选名单,是否替换现有模型,还得看自己的任务集。
Agent 能否交付,关键在中途能不能纠偏
Live Delivery 是这次发布里更贴近日常开发的一项设计:Agent 提前交付可用的初版,再逐轮完善,用户可以在过程中调整方向。配套的 Qwen-Live-Delivery-Plugin 已开源。
它针对的问题很实际。长任务如果只在结束时展示结果,需求理解出错后,后续步骤可能一直沿着错误方向累积。提前看见成果,才有机会及时纠正。
游戏开发是阿里展示的案例之一。官方称,模型可以围绕 Unity、Unreal Engine 和 Godot,从自然语言描述推进场景、逻辑、素材、材质、UI 和特效制作,并运行游戏,根据视觉与交互反馈调整镜头、动画、受击效果和灯光。示例是 Unreal Engine 猫咪巫师游戏「Meow of Magic」,还展示了通过 Blender 制作可复用 3D 模型。
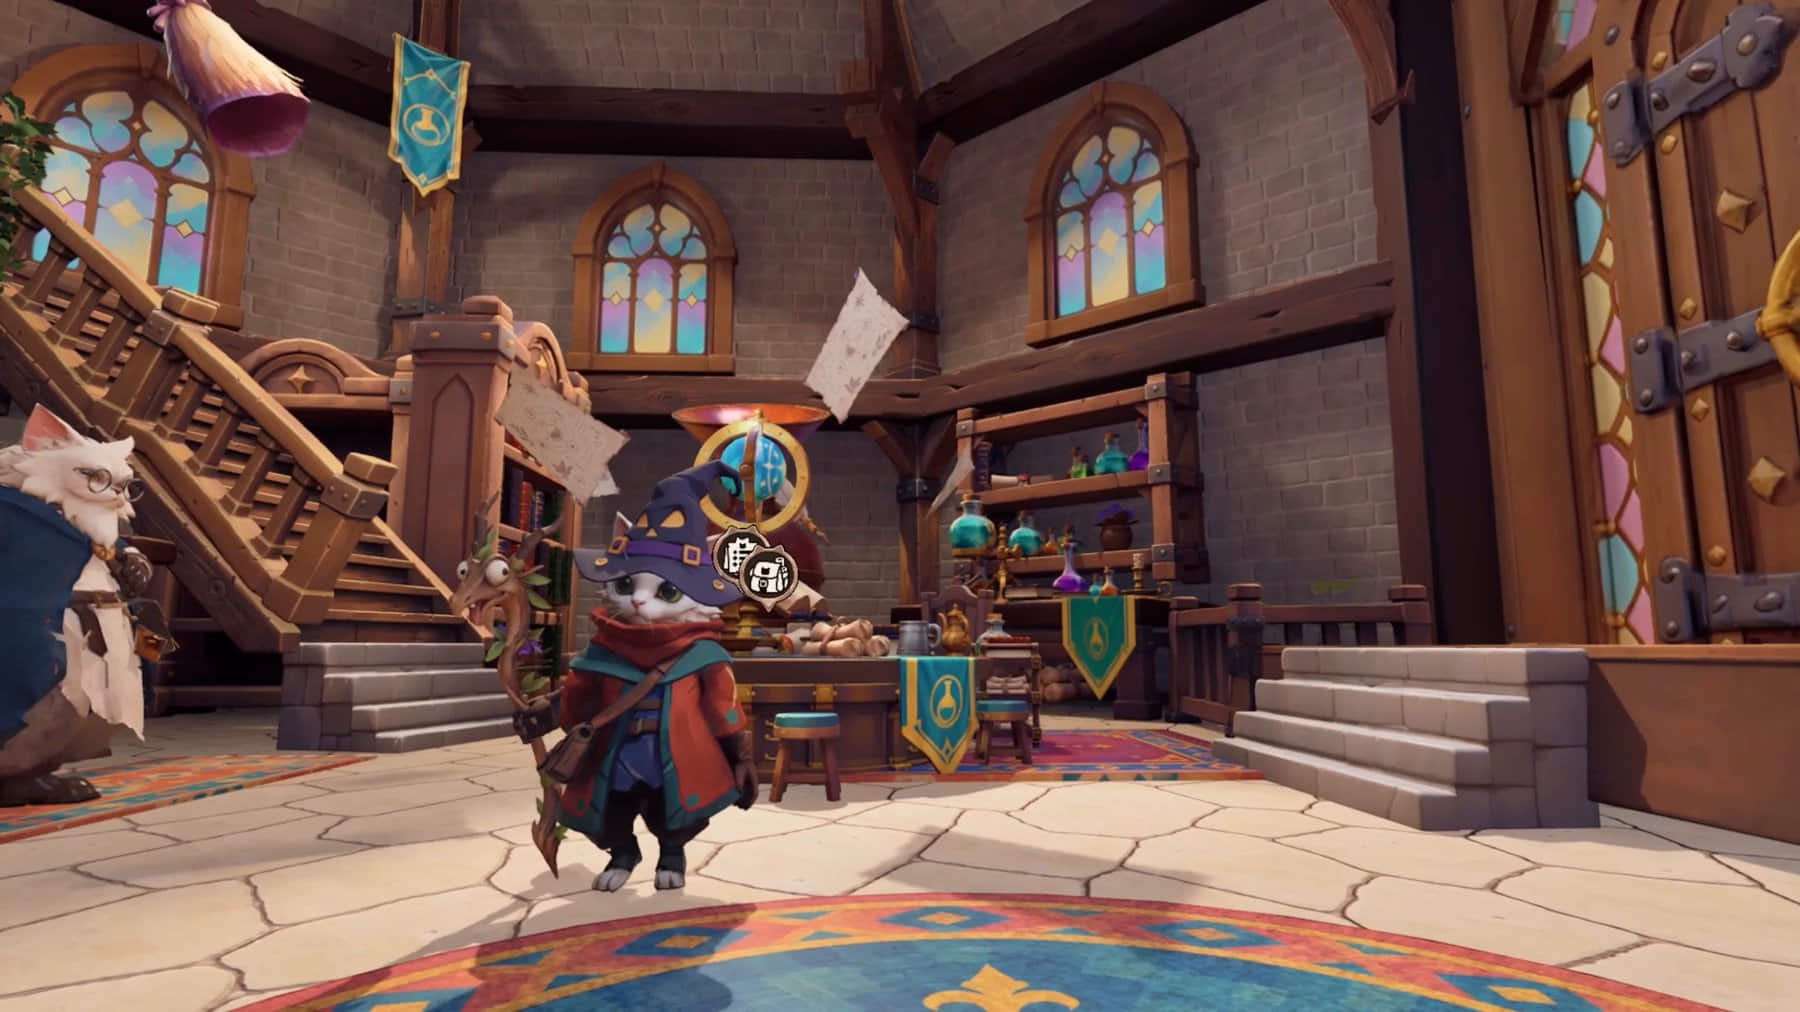
但展示一个可玩的项目,与稳定完成任意游戏需求之间,还有很大距离。原文没有提供重复运行成功率、人工介入次数或完整开发成本。
行业案例也应保留来源边界。阿里称,汽车合作伙伴 SANF、Pacific Union 将单个工件的人工编程时间从约 475 分钟缩短到 24 分钟;金融场景接入 90 个 MCP 工具,输出可追溯数字来源的 Excel 和 PowerPoint。云调度方面,配合 MindOpt,数据标注计算任务分配成本平均下降 10.42%,CPU 任务分配寻找最优解的速度超过对照方法 14 倍。
实验室案例更依赖外部系统:与 Mira 配合连续运行 48 小时,搜索 270 万个分子候选,完成四轮设计、合成和测量;与 PharmMaster 配合优化 24 个候选分子,最终候选的目标蛋白结合能力据称约为起始化合物的 3.6 倍,仍需后续实验验证。
这些是阿里披露的系统案例,不能全部归因于模型本身。
我的判断
我认可这次发布强调的两个方向:减少完成任务的 token 消耗,以及让用户在长任务中保留控制权。前者影响账单,后者影响返工成本,两者都比参数规模更接近开发者的实际收益。
但「低价挑战旗舰」仍有前提。Work360 属于阿里自建测试,行业案例也主要来自官方披露;Artificial Analysis 提供了额外证据,却不能代替你的仓库、工具链和验收标准。不同测试中的领先位置变化很大,说明选型不能只看综合排名。
安全指标尤其不能当作免审理由。Last Secure Code Bench 中,同时满足功能和安全要求的比例从 22% 升至 31.8%,三个测试层级均被评为安全的比例从 8% 升至 14.7%。进步明确,但距离放心合并代码仍然很远。内部 CBRN 审查结论也只代表所述评估范围。
原文没有给出一般团队采用 Live Delivery 后的对照数据,因此它能减少多少返工,目前仍需验证。另一个明确限制是开放权重:Qwen4-Max 已进入 QwenCloud、QwenWork、Qoder 和 QwenStudio,但计划开放的是较小的 Qwen4 模型,不能把插件开源理解为旗舰权重开放。
能拿来做什么
- 如果你正为 AI 编程选模型,可以从现有仓库抽取一组真实任务,对比 Qwen4-Max 与当前模型的验收通过率、总 token 和重试费用。用完整任务账单判断节省幅度。
- 如果你在做长流程 Agent,可以借鉴 Live Delivery,先展示可运行的初版或中间产物,再继续完善,同时保留用户修改目标的入口。
- 如果你的应用会反复发送相同上下文,可以根据实际缓存命中率核算输入、输出和缓存三部分费用,避免只用最低报价估预算。
- 如果要把生成代码合入项目,继续保留测试、审查和安全检查。原文的安全得分支持「有所改善」,不足以支持取消这些环节。