AI生成证明提速,Lean校验成瓶颈
作者测试公开的 AI 数学证明库,报告一份450行 Lean 文件单核校验耗时2.6小时,而模型可在一分钟内生成。在每秒1000 token的生成速度假设下,库中约95%的文件生成耗时低于校验耗时。
AI 深度解读
AI 写出一段数学证明,Lean 自动检查,通过后就能信任。这条链路看起来很顺,作者却发现:模型输出证明的速度,已经可能超过 Lean 首次检查的速度。一个 450 行文件,模型不到一分钟就能输出,Lean 单核检查却用了 2.6 小时。
这项测试值得程序员读,是因为它揭示了 AI 工作流里容易漏算的成本:生成结果很快,不代表验证结果也便宜。不过,原文比较的是「输出最终文件」与「检查文件」,没有计入模型推理和失败重试。这个边界决定了该怎样理解标题。
为什么几行证明能让检查器忙很久
Lean 是形式化证明工具。它根据形式化规则核验推导,避免只凭自然语言判断证明是否成立。但从源码到核验完成,中间可能包含大量搜索和计算,源码短并不代表工作少。
第一类成本来自策略搜索。策略(tactic)可以理解为给 Lean 下指令,例如简化表达式、尝试已有算术事实。具体采用哪些步骤,由 Lean 寻找。开头那个耗时 2.6 小时的 450 行文件,没有任何 decide 调用,时间花在处理策略和定义上。
第二类成本来自计算。下面这一行证明,要求检查所有小于 1,000 的自然数,其平方除以 7 的余数是否属于指定集合:
theorem squares_mod_7 : ∀ n < 1000, n * n % 7 ∈ [0, 1, 2, 4] := by decide +kernel
要看的是末尾的 decide +kernel:模型只需输出几十个 token,Lean 却要计算 1,000 个数的平方并核对余数。作者实测,这一步单核用了 1.3 秒。
这种写法在被测 AI 数学库里很常见:5,848 个文件包含 1,354,379 次 decide +kernel 调用,人类编写的主要 Lean 库 Mathlib 只有 7 次。按每 MB 源码计算,前者密度是后者的 10,668 倍。
短证明可能只是把长任务交给了检查器。
这组数据支持「这个 AI 库大量使用计算式证明」,但不能单凭调用密度,就判断这些计算都没有必要。
95% 的文件检查更慢,到底怎么比出来的
作者把每个文件的检查耗时,与模型按固定速度输出该文件所需的时间比较。这里一个 token 平均对应两三个 Lean 源码字符,生成速度分别设为每秒 100、1,000 和 10,000 token。
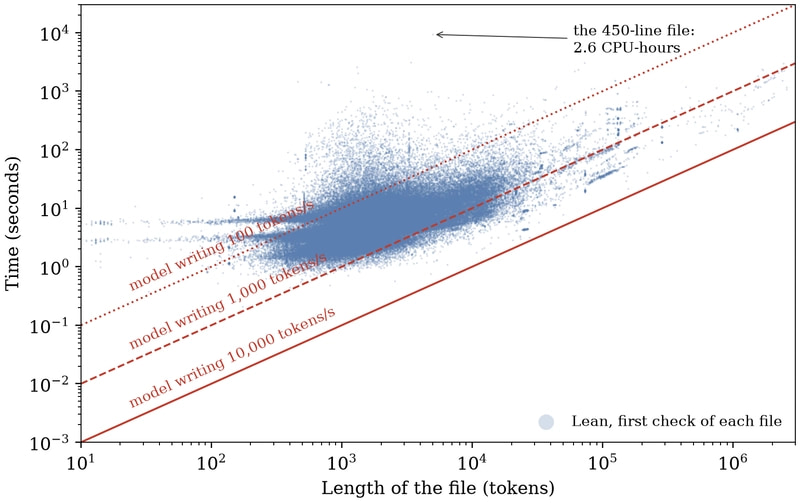
图中蓝点代表文件首次检查消耗的处理器时间,红线代表输出时间。蓝点在线上方,就表示检查比输出慢。
在测得的 162,170 个文件里,模型按每秒 1,000 token 输出,会在 95% 的文件上先完成;每秒 10,000 token 时,所有文件都是如此;即使每秒只有 100 token,也有 8% 的文件输出更快。Lean 在性能核上检查中位文件的速度,约为每秒 400 token。
作者给这些速度找了硬件参照:他们此前用 RTX 5090 运行一个 5 亿参数模型,测到每秒 11,645 token;2026 年 5 月,Cerebras 提供的万亿参数 Kimi K2.6,单流速度达到每秒 981 token。NVIDIA GB300 NVL72 运行 1.6 万亿参数 DeepSeek-V4-Pro 时,每块 GPU 面向所有用户的合计输出达到每秒 6,182 token。
单流速度和多用户合计吞吐不能混为一谈。后者更适合讨论整套服务的容量。按这个库的整体首次检查速率折算,跟上一块上述 GB300 GPU 的输出,约需 11 个性能核。
实际账单也不小。库共有 163,096 个文件,作者检查其中 162,170 个,在一台 24 核桌面处理器上耗时 31.5 小时。其余 926 个文件因部分家族占用内存过高,以及依赖关系而被排除,完整成本还会更高。
而且负载分布很偏:最贵的 1% 文件占去四分之一处理器时间;使用 decide +kernel 的文件占 3.6%,却消耗了 18% 的处理器时间。只看项目平均值,会低估少数昂贵文件的影响。
已经通过的证明,为什么还会检查得慢
首次检查时,Lean 要执行策略,得到完整证明,再将其保存。之后重新检查,可以让 Lean 的小型可信内核直接核验证明,跳过原先的搜索。
这确实有效。作者随机抽取 100 个文件,普通证明的重新检查耗时只有首次检查的 0.5% 到 6.5%。仅计算核验本身,每秒 1,000 token 的模型在其中 3 个文件上更快;每秒 10,000 token 时,则是 17 个。
但核验前还要加载依赖模块。样本中,加载耗时中位数为 4 秒,核验本身只有 0.05 秒。把加载算进去,每秒 1,000 token 的模型会在 100 个文件中的 85 个上先完成。
这里有两个不同问题:保存证明能省掉多少搜索,以及每次检查还要付出多少加载成本。优化其中一个,不会自动消除另一个。
计算式证明更难省。计算仍保留在证明内部,作者重新检查两个此类文件,耗时分别达到首次检查的 80% 和 82%。另外,一个仅 569 token、没有 decide +kernel 调用的文件,重新检查仍用了 184 秒;模型按每秒 100 token 输出它,不到 6 秒。
所以,仅凭源码长度或某个调用次数,无法可靠预测重新检查成本。
我的判断
作者最有价值的提醒,是把「可信」和「便宜」拆开讨论。Lean 检查承担着建立信任的职责,在 AI 证明训练中,其判定还是模型学习的奖励信号。即使结果可靠,验证吞吐也可能限制生产和训练速度。
但标题容易被读成:AI 完成数学证明的全过程,已经比 Lean 检查更快。实验并没有证明这一点。模型的推理、失败尝试和修正都没有计入,原文也没给出这些成本。因此,95% 是固定输出速度下的比较结果,不能当作端到端提速比例。
这项测试证明了检查容量需要单独核算,还没有证明生成全过程普遍更便宜。
另一个边界是,全部测量只来自一台机器、一个库修订和 Lean 4.34.1。作者预测推理继续加速后,检查会成为瓶颈,这有当前数据支持,但仍是趋势判断。普通团队采用不同证明风格、依赖结构或复用方式,结果可能不同。
与每次从源码重新执行策略相比,保存证明再核验,已展示出明显收益;但依赖加载和计算式证明限制了收益。至于更换硬件、调整证明写法或改变加载方式哪个更划算,原文没有对照数据,不能替它下结论。
能拿来做什么
- 如果在搭建 Lean 自动证明流水线,应把生成容量与检查容量一起规划,用每 CPU 秒处理的 token 数估算检查能力,同时记录实际耗时,避免仅根据模型输出速度扩容。
- 对检查慢的文件逐个分析,区分策略搜索、证明内计算和依赖加载,并同时测首次检查与重新检查。文件长度和项目平均值都不足以代替这些测量。
- 给验证结果附上明确的文件覆盖清单。原文这个库的默认构建只编译约五分之四文件;作者提供的 ProofServe 0.1.0 能用 Lean 自身可信内核并行重新检查已编译项目,生成检查凭据,并报告默认构建遗漏的文件。采用类似工具时,先确认「通过」具体覆盖了什么。