安卓开发基准揭示模型成本与通过率差距
Android Bench 新增结果中,GPT-6.1 Terra、Kimi K3.1 Pro 和 DeepSeek V4.1 Flash 的通过率分别为 28.7%、24.0% 和 17.3%。Kimi 与 DeepSeek 对应运行成本为 317.4 和 9.9 美元,但采用不同智能体,比较时需考虑运行框架差异。
AI 深度解读
Android AI 编程榜单里,通过率更高的模型,未必就是预算有限团队的首选。按 IT之家转述的 Google Android Bench 数据,Kimi K3.1 Pro 的通过率和平均完成度高于 DeepSeek V4.1 Flash,后者的耗时和运行成本则明显更低。
这组结果值得看,但不能只看排名。模型搭配了不同智能体,完整通过与部分完成也用了不同指标。读懂这些前提,才能判断榜单对自己的开发任务有多少参考价值。
这份榜单测的是工程任务,不能当成通用编程排名
据原文,Android Developers(@AndroidDev)于 11 月 10 日在 X 首次公开 OpenAI GPT-6.1 Terra、Kimi K3.1 Pro 和 DeepSeek V4.1 Flash 的 Android Bench 成绩,IT之家于 11 月 11 日报道。
Android Bench 是 Google 面向 Android 开发的 AI 编程基准,任务覆盖应用创建、功能开发、代码迁移和应用转换。它关注的是模型能否推进一项工程工作,而不只是补全一个函数。
这个范围也限制了结论的适用边界。Android 项目中的表现,不能直接替代前端、Node 项目中的实测;不同技术栈的构建工具、依赖和验收要求,都可能改变结果。
Kimi 完成得更多,DeepSeek 跑得更便宜
Kimi K3.1 Pro 搭配 kimi-code 智能体,在 30 项长程任务中取得:
- 通过率为 24.0%,平均完成度为 82.3%。
- 平均耗时为 27.4 小时。
- 单次基准运行成本为 317.4 美元,原文折合约 2,123 元人民币。
原文称,它的成绩高于 GPT 6 Astra、Claude Fable 5.1 和 Gemini 4 Argon,但低于 GPT 6.1 Terra 的 28.7%。报道没有给出前三款对照模型的具体分数,无法据此判断差距有多大。
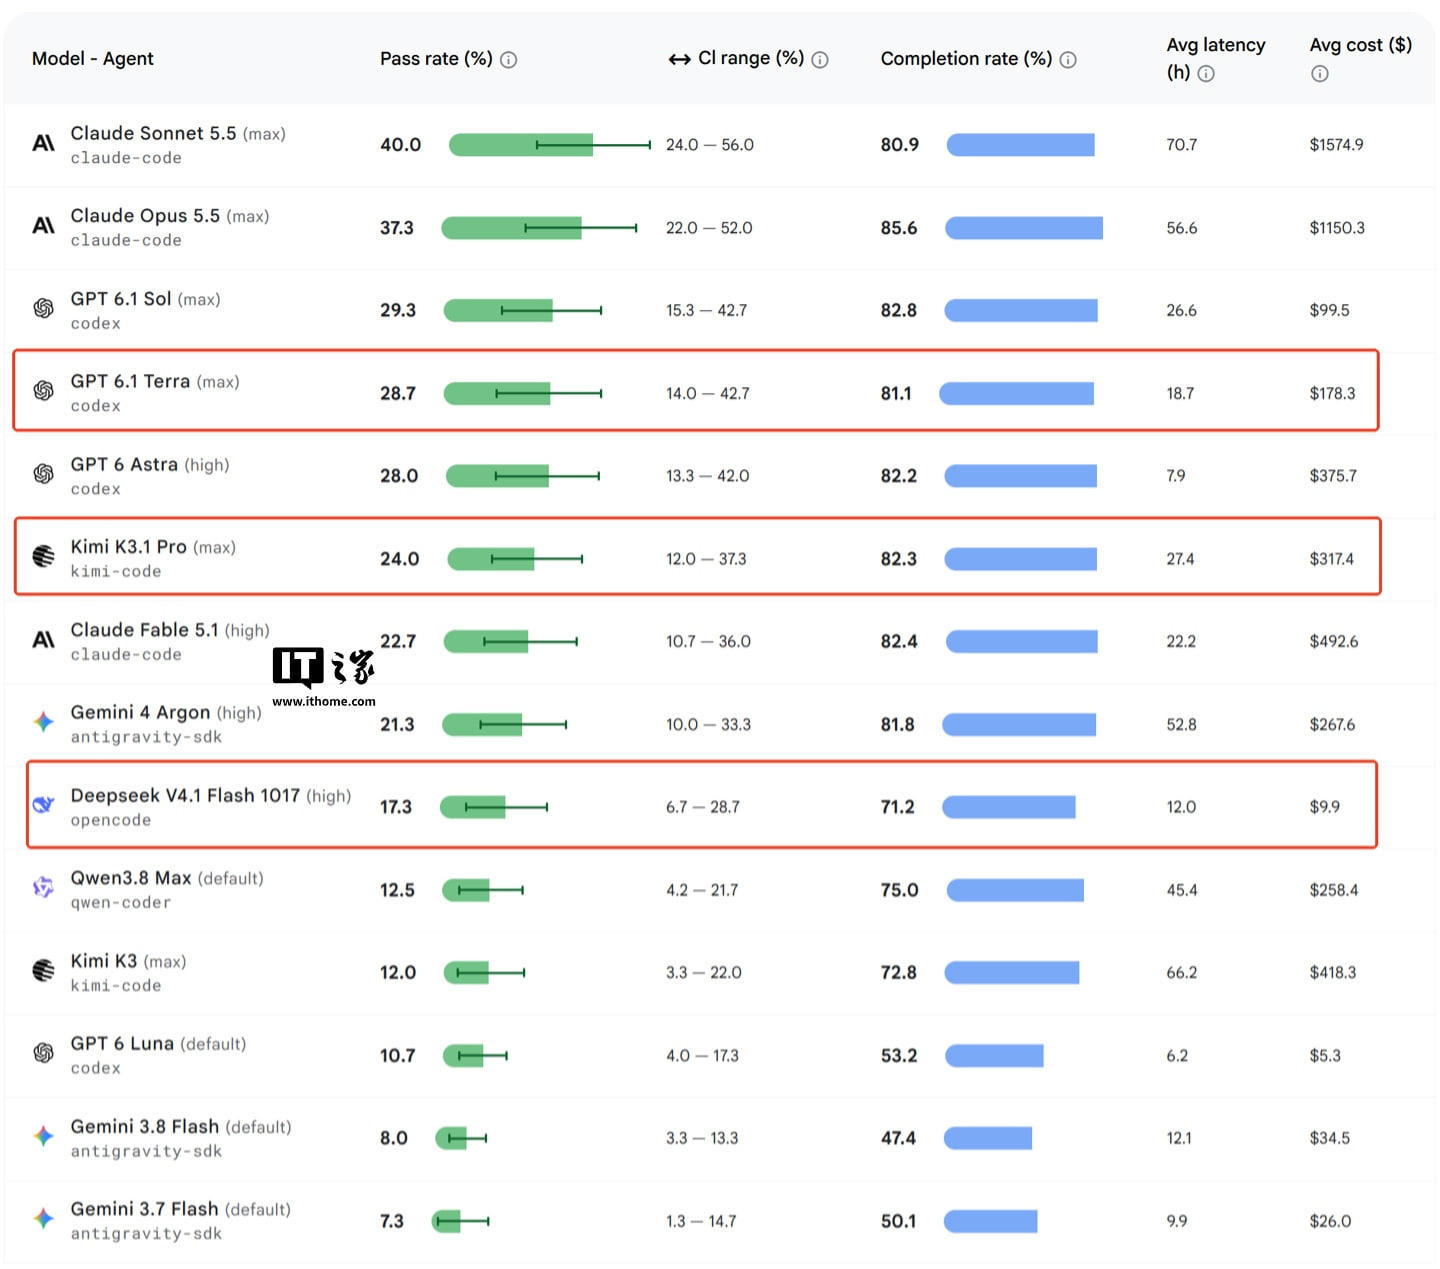
DeepSeek V4.1 Flash 1017 搭配 opencode 智能体,取得 17.3% 的通过率、71.2% 的平均完成度,平均耗时为 12.0 小时,单次基准运行成本为 9.9 美元,原文折合约 66.2 元人民币。
这组数据呈现的是完成能力、耗时与成本之间的取舍。
不过,别把这些成本理解成「开发一个应用要花多少钱」。报道写的是单次基准运行成本,没有进一步解释成本统计范围;平均耗时的计时口径、并发设置和重试方式,也没说清。
平均完成度超过八成,为什么通过率只有两成多
Kimi 的 82.3% 平均完成度看起来很高,但通过率只有 24.0%。两个数字回答的是不同问题:任务推进到了什么程度,以及最终是否满足通过要求。
对工程交付来说,这个区别很实际。代码写出大部分,与最终能验收之间,可能还隔着构建、集成或功能细节。不过,原文没有提供失败案例,也没有解释完成度如何计算,不能断言这些模型具体卡在哪一步。
平均完成度不能当作交付成功率。
另一个容易忽略的变量是智能体。Kimi 使用 kimi-code,DeepSeek 使用 opencode。智能体负责组织工具调用和执行流程,因此这次比较包含了「模型与智能体组合」的差异,不能把全部分差都归因于模型本身。报道也没有给出两款模型在同一智能体下的对照结果。
我的判断
这份报道有用的地方,是同时列出通过率、完成度、耗时和成本,让读者能看到排名背后的代价。
但「DeepSeek 尤其适合预算、响应时间敏感的团队」,仍是根据这次成绩作出的选型判断。长程任务的平均耗时,也不能直接代表日常聊天或代码补全的响应速度。原文没有团队落地对照数据,尚不足以证明它在具体项目中更划算。
低运行成本值得关注,后续人工修复需要多少时间,同样会影响总成本。相较直接按榜单采购,用自己项目里的代表性任务试跑,更能回答实际选型问题。
能拿来做什么
- 如果你在做 Android 开发,可以分别选取功能开发和代码迁移任务,对照测试候选模型,并保持验收条件一致。
- 在日常 AI 编程中,同时记录最终通过情况和人工修改时间,避免把「生成了很多代码」当成任务完成。
- 做预算评估时,记录智能体名称、运行费用、耗时和重试次数;这篇报道已经展示了,不同组合的成本差距可能很大。
- 如果主要写前端或 Node,可以把这份榜单作为候选线索,再用自己的构建、测试和功能验收流程验证适配程度。