研究Agent迁移:从沙箱文件到会话状态
开源LINE研究机器人通过规划、搜索比较和报告撰写三个阶段生成带来源引用的报告,并支持追问深化及历史版本快照。文章围绕从Python Managed Agents迁移到Go ADK,讨论以会话状态承接原有沙箱文件的设计。
AI 深度解读
把一个 Python 研究机器人改写成 Go,最有价值的变化未必是语言。作者真正替换的是运行方式:从依赖托管 Agent 的沙箱、文件和轮询,转向自己控制的 ADK Agent,用 Firestore 保存研究进度,再让 Cloud Tasks 驱动长任务。
这篇值得读的地方,是它把「模型能回答问题」之后的工程账摊开了:跨轮记忆放哪里,结构化输出为什么仍会出错,通知失败会不会重跑付费流程,以及同一个服务怎样完成迁移。
为什么要离开托管 Agent
这个 LINE Bot 的任务很明确:收到研究问题后,依次执行 PLAN → SEARCH_COMPARE → WRITE_REPORT。先设计 4–8 组搜索关键词,再通过 Google Search + URL Context 阅读网页、比较共识与分歧,最后生成带脚注引用的繁体中文 Markdown 报告。
Cloud Run 把报告转成 HTML,上传 Cloud Storage,再向 LINE 推送 Flex 卡片。用户继续要求「深入第二章,补充日文来源」,系统会沿用研究内容,版本号 +1,并保存旧版快照。
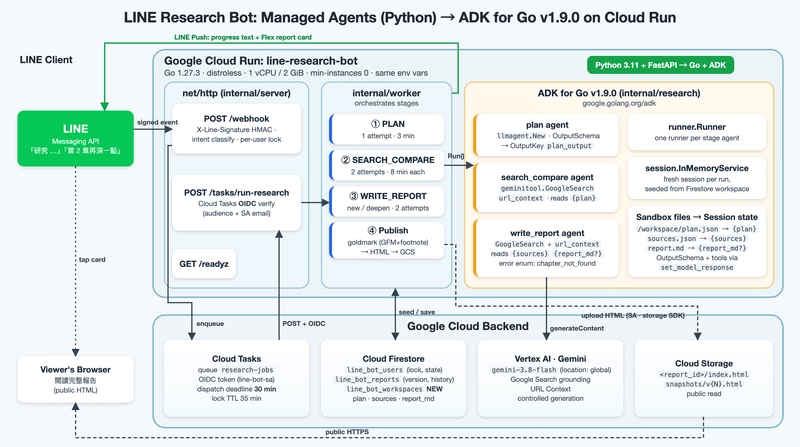
旧版使用 Python 3.11、FastAPI 和 google-genai,通过 enterprise=True 调用 Pre-GA Managed Agents API。同一个 environment_id 下,/workspace/plan.json、/workspace/sources.json、/workspace/report.md 可以跨轮保留。
问题是,这份便利附带平台约束。base_agent: antigravity-preview-05-2026 仍属预览服务,没有 SLA;沙箱里的 gsutil 是模拟实现,报告最终仍要塞进 JSON,由 Cloud Run 上传。文件系统实际主要承担了「记住三个文件」的工作。
调用也需要 background=True,每 3 秒轮询一次。作者曾把等待超时从 240 秒调到 600 秒。
因此,这次迁移应理解为「托管 Managed Agent → 自己控制的 ADK Agent」,而不是 Python ADK 换成 Go ADK。新版采用 google.golang.org/adk v1.9.0,拆成三个 llmagent,提示词通过 go:embed 编入程序,只给需要检索的阶段配置工具。
runner.Run() 返回 Go 1.23 的 iter.Seq2[*session.Event, error],应用直接消费事件,用 context.WithTimeout 控制超时。轮询消失了,但任务执行、状态持久化和错误恢复,也随之成为应用自己的责任。
跨轮记忆应该属于业务数据
最关键的一步,是把「Agent 记得文件」改成「服务保存研究工作区」。
ADK 的指令模板支持 {sources}、{plan} 这样的状态引用,{report_md?} 表示允许缺失。模型需要历史资料时,应用先把数据填入 Session State,再执行对应阶段。
下面这段代码解决的是:新建会话时,怎样注入上一轮的来源和报告。
created, err := a.sessions.Create(ctx, &session.CreateRequest{
    AppName: a.appName,
    UserID: userID,
    State: map[string]any{KeySources: in.SourcesJSON, KeyReportMD: in.ReportMD},
})
要看的是 State 这一行:历史资料来自应用传入的数据,不依赖模型自行找到旧文件。
作者没有把 session.InMemoryService() 当成长期存储。Cloud Run 会横向扩容,也能缩容到 0,内存随时可能丢失。每个阶段都新建会话,从 Firestore workspace 恢复状态,执行后写回 Firestore,再删除会话。
跨轮记忆一旦成为业务数据,重新发布报告就不必再调用模型。
旧版 retry_publish 还要让 Agent 读取 report.md 并返回;新版直接取出 Markdown,重新渲染上传。这个收益来自状态归属调整,与 Go 的执行速度没有直接关系。
代价也要看清。旧版沙箱文件不能直接被新版访问,作者采取的是提示过期并重新研究,没有展示历史文件搬迁方案。
模板还有一个容易漏掉的坑:匹配 {identifier} 的内容可能被当成状态变量。作者清理了提示词中的 JSON 示例,并用单元测试把允许的占位符限制为 {plan}、{sources}、{report_md?}。
有了 OutputSchema,为什么还会发布空报告
旧版靠提示词要求「只返回 JSON」,再尝试解析原始文本、Markdown 代码围栏,或者首尾大括号之间的内容。
新版使用 OutputSchema。按原文描述,ADK 会注入 set_model_response 工具,让模型先调用检索工具,再提交符合 Schema 的结果,最后通过 OutputKey 写入状态。URL Context 在这个版本里还需要用 geminitool.New 包装 genai.Tool,不能直接照搬内置的 geminitool.GoogleSearch{}。
作者在重写前先写了约 30 行探针,验证自己的 GCP 项目在 global 位置能否同时使用 Google Search、URL Context 和 OutputSchema。这个顺序很实用:先验证最可能推翻设计的组合,再写业务代码。
但 Schema 没有包办业务正确性。
切换到 gemini-3.8-flash 后,作者观察到报告从约 5k 字符增长到 11–12k 字符。测试要求深入不存在的「第 99 章」时,模型却返回 chapter_not_found_chapter_not_found,并给出空的 available_chapters。
原来的判断是 == "chapter_not_found",没有识别这个值,流程便可能把空 report_md 发布成新版本。
作者补了三层处理:Schema 的错误字段使用 enum,只允许 chapter_not_found;worker 用 strings.Contains 兼容异常值,章节列表为空时从原报告的 ## 标题提取;最后,无论错误字段怎样返回,空报告都禁止发布。
结构化输出约束格式,业务代码仍要守住发布条件。
模型升级也有成本:三阶段总耗时从约 60 秒升到 150–190 秒。原文没有给质量评分或成本对照,不能只凭报告变长就判断升级更划算。GEMINI_MODEL 被设为可选环境变量,方便替换模型;每次替换仍需要重新验证这些边界。
我的判断
我更认可这篇的工程拆分,而不是「重写成 Go」这个表层结论。Python 同样可以用数据库保存状态、用队列执行任务、校验 OIDC,也可以把通知失败与研究失败分开。原文没有对照实验,无法把改善归因于语言。
上线部分尤其值得保留:长任务的有效期限取决于整条链路。Cloud Run 超时是 3600 秒,但 Cloud Tasks HTTP 任务默认调度期限只有 10 分钟,队列又设置了 max-attempts=3,超时可能导致重复研究。
作者显式把任务期限设为 30 分钟:
Task: &cloudtaskspb.Task{
    DispatchDeadline: durationpb.New(30 * time.Minute),
    MessageType: &cloudtaskspb.Task_HttpRequest{HttpRequest: &cloudtaskspb.HttpRequest{ /* ... */ }},
},
要看的是 DispatchDeadline,单独调大 Cloud Run 超时补不上这一层。用户锁 TTL 也从 300 秒改成 35 分钟,任务完成后主动释放,并用 context.WithoutCancel(ctx) 避免请求取消阻断解锁。
不过,锁、超时和重试分类还不是完整的幂等方案。原文没说清任务在「报告已上传、状态尚未写回」等位置中断后怎样避免重复发布,这里仍要打问号。
另外,服务为接收 LINE Webhook 开启了 --allow-unauthenticated,内部任务入口便需要自己验证 OIDC。作者用 idtoken.Validate 校验 audience,再检查 Service Account 邮箱;创建任务和接收任务双方统一使用 CLOUD_RUN_SERVICE_URL + "/tasks/run-research"。
最终 LINE 推送失败只记录日志,不让整条研究流程重跑,这个取舍合理。但若要保证通知最终送达,还需要单独的补发机制,原文没有展开。
作者称通过了 go test ./... 和真实 Vertex AI 集成测试,另有一次生产 E2E 耗时约 33 秒。它与前述 150–190 秒不是同一项测量,不能混作性能结论;所给原文在 E2E 结果描述处截断,完整验收结果也无法据此确认。
能拿来做什么
- 给研究助手或日常 AI 编程工具做跨轮任务时,把计划、来源、产物和版本存入业务存储。会话负责一次执行,工作区负责持续恢复,也方便重新渲染和发布。
- 在 Node 或 Go 的模型调用层同时设置 Schema 校验和业务校验。不存在的章节、空产物、缺失字段都应有明确分支,尤其要验证模型升级后的异常输出。
- 给队列任务画清超时和重试关系,分别检查执行期限、锁 TTL、存储失败与通知失败。报告已经生成后,消息发送失败不应自动触发整轮付费检索。
- 迁移在线服务前先运行
gcloud run services describe核对真实配置,再用--no-traffic --tag=golang部署并测试。作者保留了原有 11 个环境变量,但这个结果依赖部署回同一服务;不要直接把仓库里的旧脚本当成线上配置。