英伟达以分层存储缓解智能体显存压力
英伟达介绍通过低精度压缩、跨 GPU 分布及 CPU 和存储侧上下文迁移,降低权重与 KV 缓存对 HBM 的压力。其援引基准称,在指定输出速度下,新平台每美元智能体吞吐量最高提升30倍,而单 GPU HBM 仅增加约3%。
AI 深度解读
HBM 只增加约 3%,每美元智能体吞吐量却最高提升 30 倍。英伟达给出的解释是:推理效率取决于整套系统怎样压缩、存放和搬运数据,单看 GPU 显存容量已经不够。
这条消息值得程序员关注,因为长上下文、RAG 和智能体都会产生持续增长的内存开销。不过,30 倍是特定基准和服务速度条件下的平台对比,不能直接当成自家 AI 应用的提速预期。
显存为什么越来越不够用
据 IT之家 11 月 6 日报道,英伟达在 11 月 5 日发布技术解读,指出模型参数、上下文长度和智能体应用正在共同推高 GPU 显存需求,并判断 HBM 供应紧张、价格上涨的局面还会持续。
推理时,HBM 主要承担两类负担:模型权重,以及 KV 缓存。后者保存模型处理上下文时产生的中间结果,供后续生成复用。
智能体会在多次模型调用、工具调用之间携带历史上下文。原文提到,部分场景需要处理多达 300 万个 token。RAG 又会把检索到的企业资料加入提示词,进一步扩大上下文。
容量之外,还有带宽限制。英伟达用仓库和装卸口作比喻:仓库扩大了,装卸口却跟不上,货物仍然周转不动。对应到推理系统,就是更多显存未必能转化成更多有效输出。
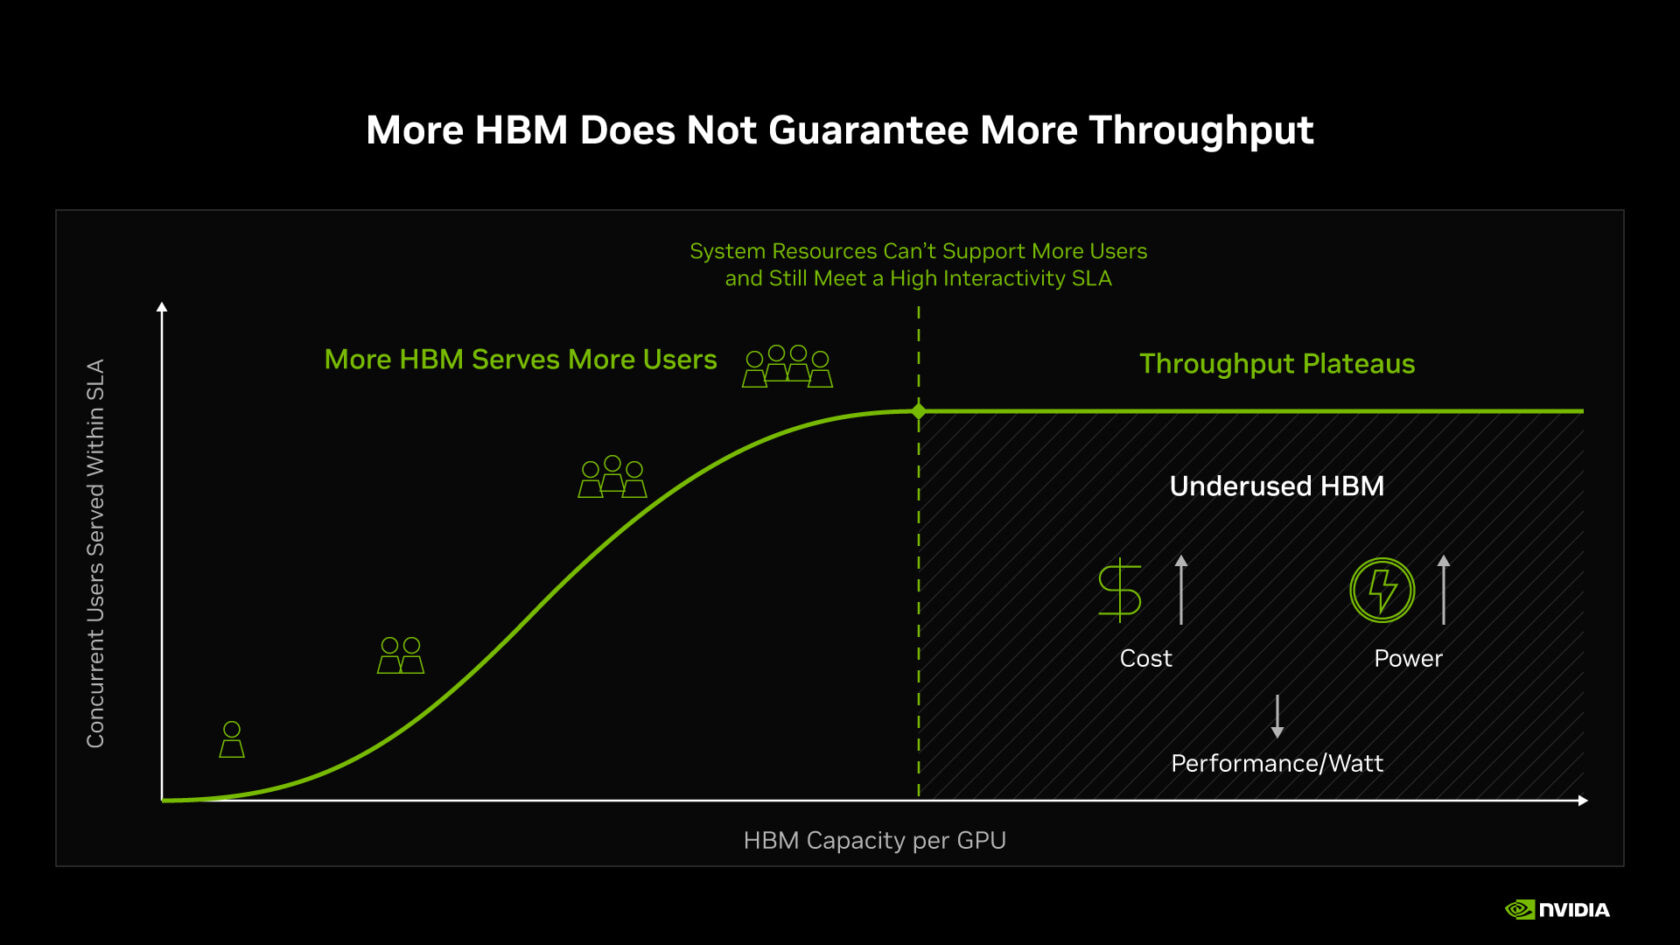
英伟达怎样让数据少占显存、及时回来
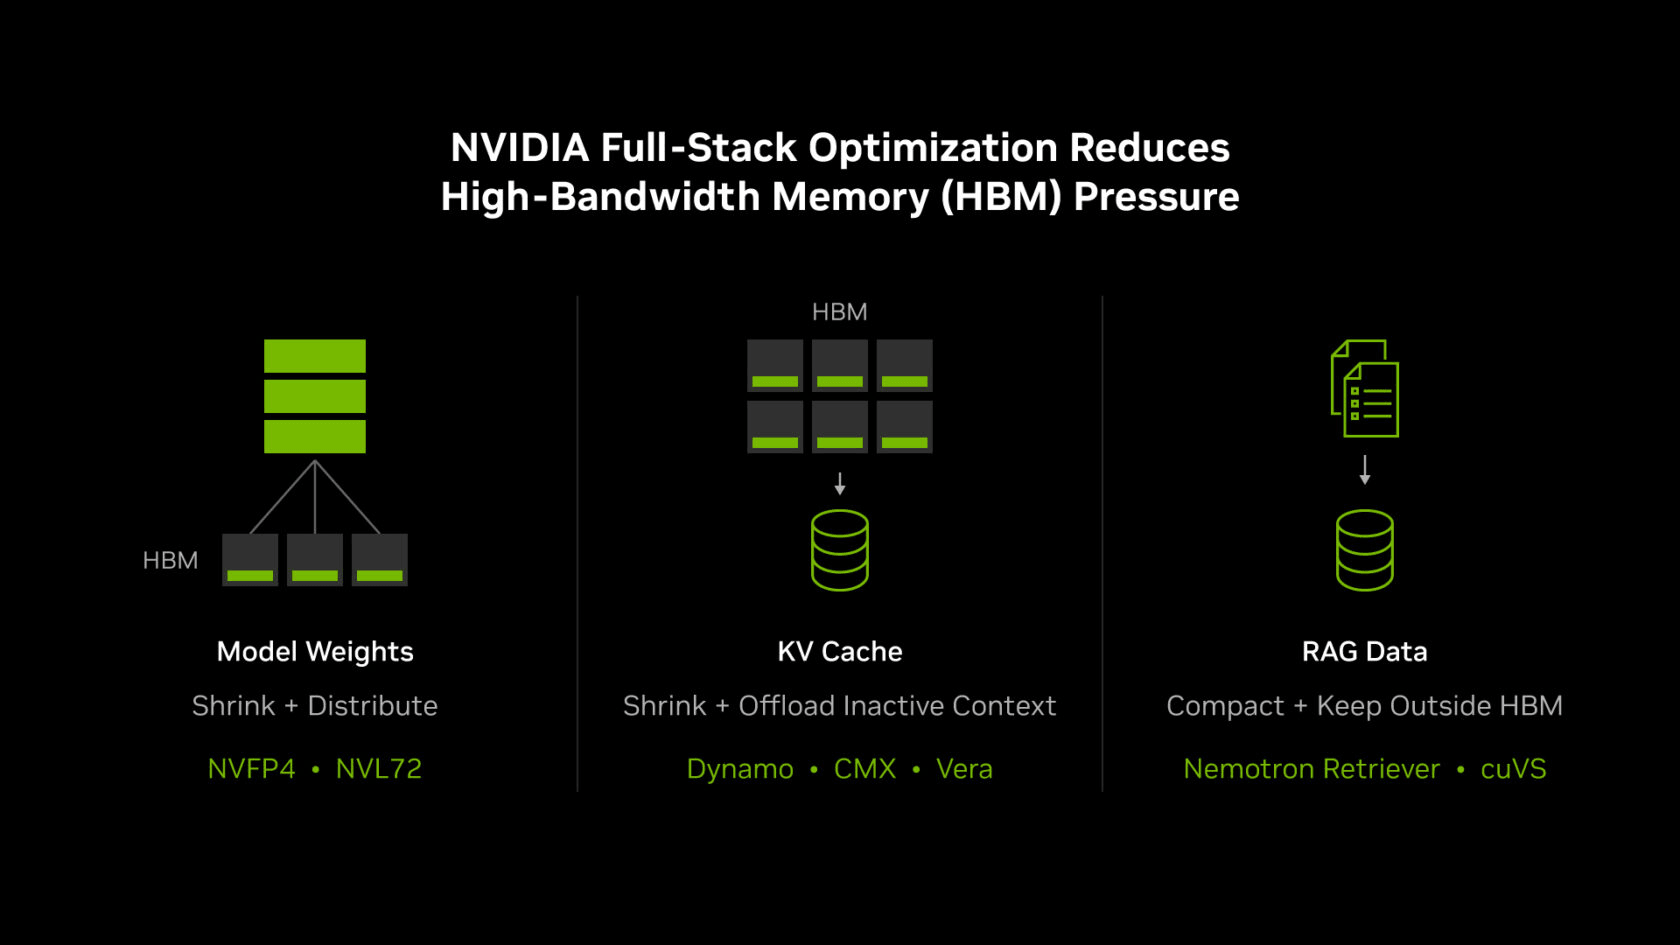
英伟达提出的「全栈协同设计」,是把 GPU、CPU、网络、存储和软件一起考虑。它要解决的具体问题是:哪些数据必须留在 GPU,哪些可以暂时移走,什么时候再取回来。
原文列出了几项做法:
- 用 NVFP4 低精度格式压缩模型权重和 KV 缓存,减少需要保存和搬运的数据。
- 在 NVL72 系统中,把模型权重分散到最多 72 颗 GPU 上。
- 用 Vera CPU 的大容量 LPDDR 内存,为暂停的上下文提供就近缓冲。
- 由 Dynamo 推理软件把不活跃上下文迁移到 CMX 上下文存储,并在复用前取回。
- 把 RAG 索引保留在 CPU 和存储侧,避免长期占用 HBM。
这些手段分别处理数据体积、容量分担和存储位置。它们需要配合:把上下文移出去能腾出显存,但如果取回太晚,请求仍然要等。
关键是让活跃请求拿得到数据,同时减少不活跃数据对 HBM 的占用。
30 倍提升究竟比较了什么
英伟达援引 SemiAnalysis AgentX 基准称,在每用户每秒 125 token 的条件下,Vera Rubin NVL72 相较 GB300 NVL72,每美元智能体吞吐量最高提升 30 倍,而每颗 GPU 的 HBM 容量仅增加约 3%。
另一组数据是:在每用户每秒 100 token 的条件下,GB300 NVL72 相较 H200 平台,每美元吞吐量最高提升 10 倍。
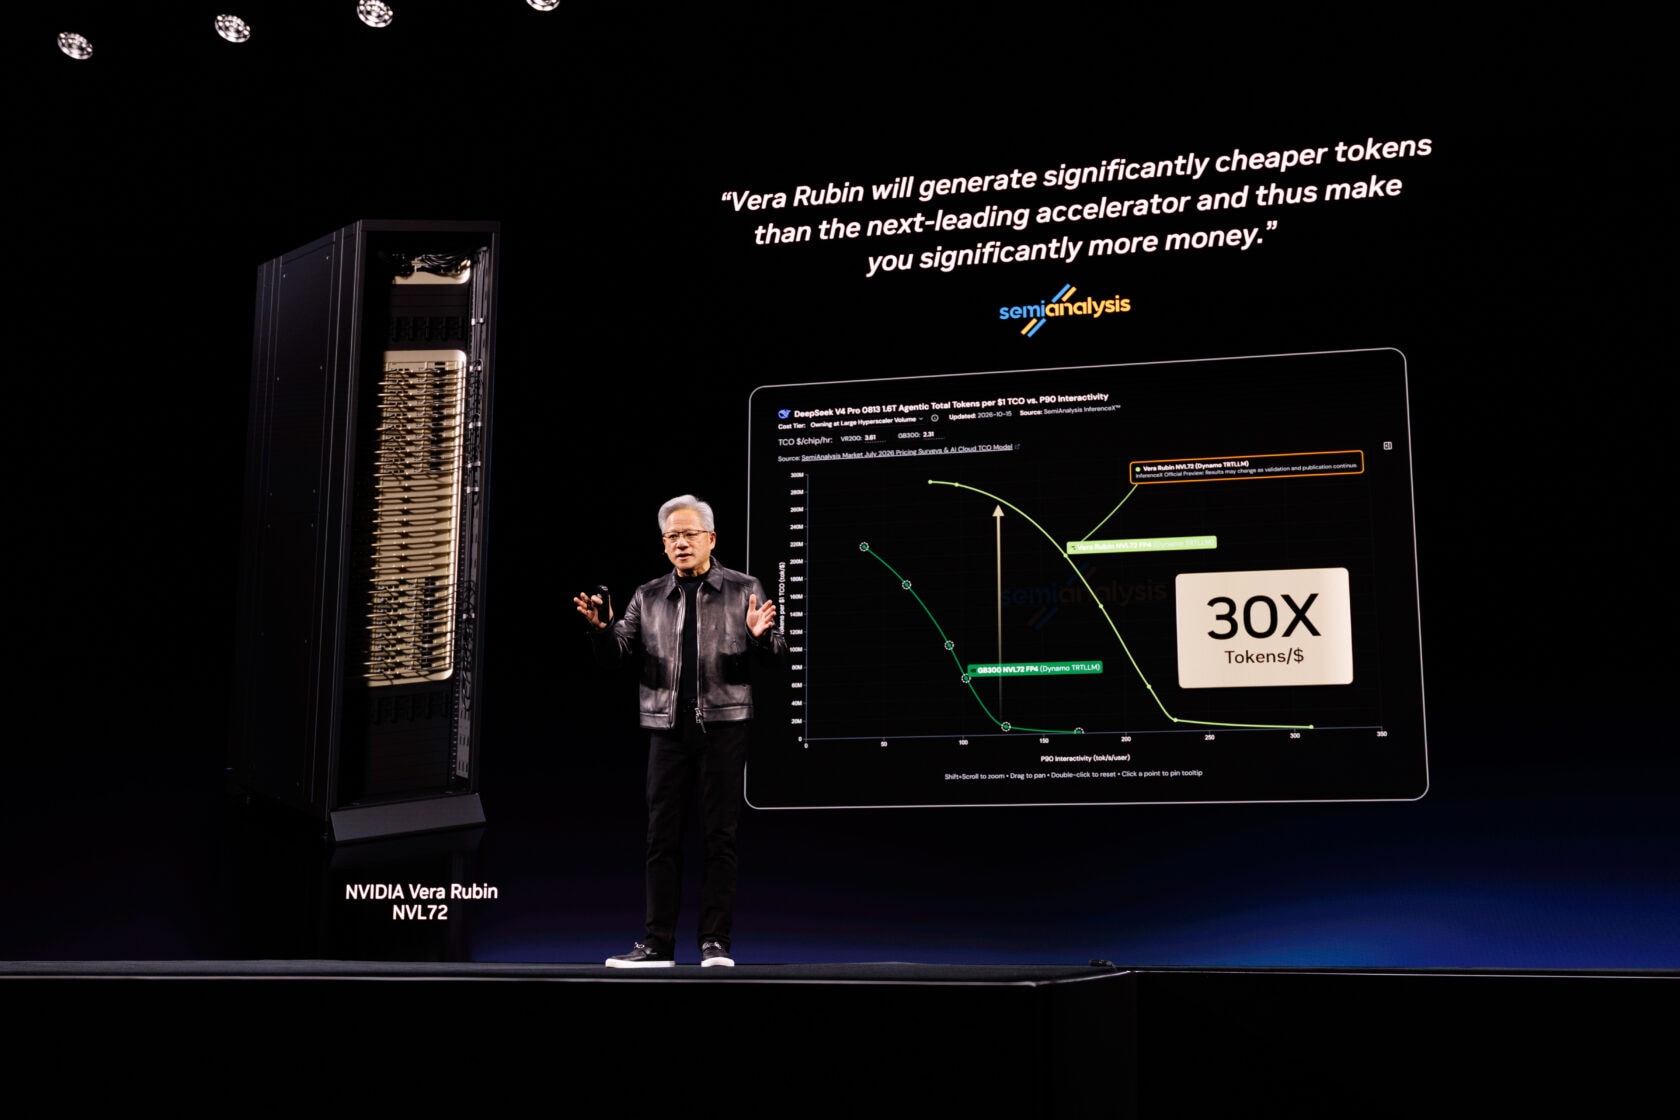
这里比较的是带有服务速度约束的成本效率,不是单个请求生成速度提升了 30 倍。两组对比的每用户输出速度条件也不同,不能直接拼成一条连续增长曲线。
每颗 GPU 的 HBM 只增加约 3%,也不代表整套系统的内存、存储或成本只增加了约 3%。原文介绍的方案恰恰使用了 HBM 之外的资源。
我的判断
我认同它对问题的拆解:面对长上下文和智能体,除了购买更大显存,还应该检查数据是否被合理压缩、是否一直占着昂贵内存,以及搬运能否跟上请求。
但 30 倍不能单独归功于内存优化。这里比较的是不同代际的整个平台,GPU、CPU、互连和软件都有可能参与贡献。原文没有提供各项优化单独开启、关闭的对照数据,也没交代完整的成本口径、测试负载和量化后的质量变化,因此无法判断每项措施贡献了多少。
和直接增加 HBM 相比,分层存储能利用更多类型的内存与存储资源,同时也引入迁移和调度问题。普通团队能否获得收益,要看请求是否有明显的暂停、复用,以及取回数据的开销是否可控。
能拿来做什么
- 做智能体或 RAG 服务时,先记录上下文长度、历史携带量和检索内容量,确认显存压力具体来自哪里,再决定是否扩容。
- 如果负责推理部署,可以检查运行时是否支持 KV 缓存管理和上下文迁移,并验证恢复请求的等待时间;仅做前端或 Node API 接入时,应先确认服务商提供了哪些相关能力。
- 评估平台报价或基准时,同时核对每用户 token 速度、并发条件和成本口径,把「最高提升」与自家负载下的实测结果分开。
- 尝试低精度格式时,把输出质量与吞吐量一起验收。原文没有给出 NVFP4 在这些测试中的质量对照,不能只按节省的显存作决定。