Agnes Harness 开源,宣称最高提速14倍
Agnes Harness 采用双系统决策和双层自进化设计,已开放源码。报道宣称其最高提速 14 倍,成本最低降至原来的 1/27,摘录未交代测试条件。
AI 深度解读
Agnes Harness 想省下的是 Agent 接入每家企业后反复适配的钱。它让 9B 模型接管常见决策,让大模型处理复杂判断,再把验证过的执行经验存成操作手册,供下一次任务复用。
原文标题里的「最高提速 14 倍」来自一次模拟任务的平均单步决策耗时。另一项更接近实际使用的仿真里,机器狗完成整个任务的时间缩短了 32.9%。把这两个数字放在一起看,才能判断这套设计对自己的工作流有没有用。
快模型接管哪些决策,能省多少钱?
Agnes Harness 把决策分给两套系统。System 1 是通过插件接入的 9B 模型 Agnes Sys1.0,负责判断下一步调用哪个工具、继续等还是立即执行,以及什么时候把问题交给负责复杂推理的 System 2。像「称重台还没稳定,再等一会」这种判断,一次任务里可能反复出现,调用成本也会跟着累积。
按 Agnes Harness 报告披露的数据,模拟家庭漏水任务里,大模型平均花 7.6 秒判断下一步,Agnes Sys1.0 用了 0.53 秒,耗时相差约 14 倍。另一组行李房测试要求称重、竖直摆放和暂存物品,两套系统各做了 100 次判断,在线大语言模型单次约花 0.00247 美元,Agnes Sys1.0 约花 0.000091 美元,后者约为前者的 1/27。
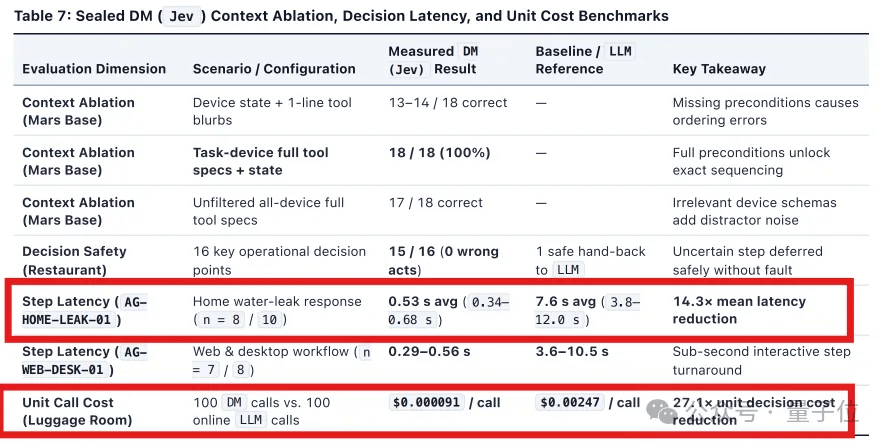
整条流程有另一笔账。仿真里,机器狗要在室内找到门并穿过去。相较于每一步都调用大模型,双系统把全程耗时缩短了 32.9%。工具执行、等待设备和转交大模型都会占用时间,单步收益能传到全程多少,取决于这些环节各自占多少。
新任务临时补课,执行经验怎么留下?
测试时训练(TTT)处理眼前的任务。Agnes Sys1.0 先根据任务生成带标准答案的练习,再用练习结果调整末端一小组校准参数。9B 主体参数保持固定,任务结束后恢复这组临时参数。这样,新设备的适配就有了一个范围明确的入口。
长期经验由 RSI 处理。Agnes Harness 回看执行记录,找出反复报错和耗时的步骤,再调整 Prompt、Memory、Skills 和 Subagent 的配合方式。改法要先经过任务中的验证和仿真测试,通过后才会写入版本化 Playbook,供后续任务复用。
原文举了一次设备入库验收。Agent 在称重台还没稳定时就读取重量,操作顺序也出了问题,最后跑了 30 分钟仍然超时。这个案例说清了复盘要找什么。至于修改后用了多久、后续验收成功率有没有提升,原文没给数据。
从业务插件到真实设备,接入边界在哪?
业务工具、模型适配器、工作流、Skills 和操作界面都可以封装成插件,已有业务系统也可以通过 MCP 接入。按报道,Agnes Harness 采用 Apache 2.0 许可证,允许商用,当时有 2.1k GitHub Star,体验需要本地部署。运行环境要求 Node.js 24.10 及以上和 pnpm 10.34.5,调用云端模型 API 时无需额外配 GPU。
量子位作者把 GitHub 地址交给 DeepSeek Harness,大约 50 分钟后在 MacBook Air 上跑通。系统支持项目提供的 Demo 模型,也可配置自己的模型 API。作者做的审稿插件找出了 6 处问题,并给出位置、类型和修改建议。新开会话说一句「帮我审稿」就能触发插件。升级时,新会话可以用新版本,在跑的任务继续沿用原版本。
硬件侧使用 MHS(Model Hardware Standard)描述设备状态、可执行动作和返回数据。Agnes Harness 据此安排设备的调用顺序,实时控制和物理安全仍由设备控制器负责。原文称,MHS 正以官方插件形式接入新版本。
我的判断
这套设计最值得借鉴的是先看每一步需要多少判断,再决定用什么执行。如果工具调用条件已经能用状态码、字段校验或固定等待规则表达,普通代码就能处理。遇到输入有变化、规则逐渐难写的步骤,再比较小模型的速度、误判率以及向大模型求助的频率。原文给了与在线大模型的对照,没有给规则路由或其他轻量模型的对照,TTT 临时补课和 RSI 经验复用各自带来多少收益也还停留在设计和案例层面。
官方的阶段性自评覆盖 9 项基准,6 项在对照组中排第一,另有 1 项与 Codex 并列第一。DeepPlanning 得了 87.07 分,BigCodeBench-Hard V1 的通过率是 40.69%。这些结果可以用来判断后续该测哪些能力。换到自己的任务,还得看误判或重试带来的返工,以及包含模型调用、设备等待和人工介入在内的全程成本。开头「开发从 90 块降到 1 块,适配仍要 10 块」是 Zaniel 用来解释成本结构的比方,原文没有给出跨客户复用后实际省下的适配费用。
能拿来做什么
- 给现有 Node.js Agent 记录每一步的模型耗时、工具耗时和转交原因,挑一个调用频繁的步骤,用同一批任务比较原方案与分流方案的成功率、全程耗时和单任务成本。
- 把审稿这类可重复的 AI 编程辅助任务做成有版本的插件,用固定样例验证触发条件和结果格式,并在任务启动时记录它使用的版本。
- 遇到工作流超时,先把触发条件、失败步骤和改法写成可重放的用例。复跑验证通过后再更新 Playbook,涉及外部设备时先在仿真里验证。