SvelteKit 聊天应用接入工具执行审批
教程用约 150 行代码搭建 SvelteKit AI 聊天页,通过服务端路由调用模型,并要求用户批准后才执行 add_task 工具。界面采用作者维护的 MIT 组件库 aparté,提供完整示例及无需密钥的模拟演示。
AI 深度解读
给 SvelteKit 加一个 AI 聊天框,难点不只是把模型的回复显示出来,还包括:工具什么时候执行、用户在哪里确认、密钥放在哪里,以及执行结果怎么回到对话里。作者用 AI SDK 和 aparté,把这些环节接成了一个约 150 行的任务清单示例。
它最值得参考的是执行顺序:模型先提出操作,页面展示参数,用户批准后才真正添加任务。不过,这仍是一份演示教程,距离生产环境还有鉴权、持久化和服务端权限校验需要补齐。
模型负责提出操作,页面负责等待批准
作者把聊天系统分成两部分:Vercel AI SDK 提供消息、流式响应和工具调用;aparté 提供聊天界面、审批交互和工具展示。按原文的说明,AI SDK 现成的聊天组件面向 React,Svelte 页面需要另配 UI。
aparté 是作者维护的 MIT 库,以 Web Components 为基础,外面提供 Svelte 薄封装,也有 React、Vue 和 Angular 封装。教程使用的版本是 SvelteKit 3.1、Svelte 5.57、AI SDK 7 和 aparté 1.0.2。
示例只开放一个工具:add_task。模型可以提出任务标题和截止日期,但不能立即修改清单。下面这段注册代码定义了参数、审批要求和实际执行逻辑:
aparteGlobalConfig.registerTool(
  {
    name: 'add_task',
    description: "Add a task to the user's list.",
    inputSchema: {
      type: 'object',
      properties: {
        title: { type: 'string' },
        due: { type: 'string', description: 'Due date, YYYY-MM-DD' },
      },
      required: ['title'],
    },
    needsApproval: true,
  },
  async (call) => {
    const task: Task = {
      title: String(call.input['title']),
      due: call.input['due'] ? String(call.input['due']) : undefined,
    };
    tasks.push(task);
    return { toolCallId: call.id, content: `Added "${task.title}".`, structuredContent: task };
  },
);
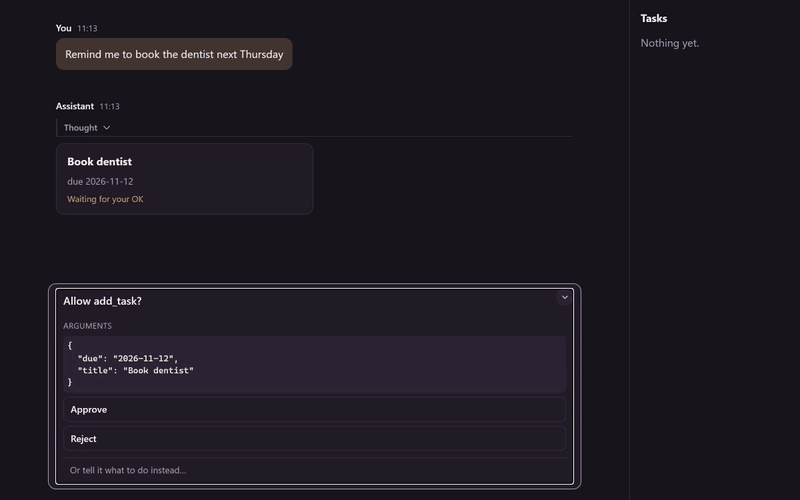
关键是 needsApproval: true。模型发出调用后,流程会停在处理函数之前,等用户选择 Approve 或 Reject。
模型提出调用,不等于工具已经执行。
批准之后,浏览器里的处理函数才会执行 tasks.push(task)。返回值中的 content 给模型阅读,structuredContent 则把结果保留为数据,供界面组件使用。
用户也能直接输入「不,改成周五」。按作者描述,这会拒绝当前调用,再把这句话作为工具结果交给模型,让它重新提出操作。审批因此不只是一个确认按钮,也是纠正模型参数的入口。
密钥留在服务端,但执行循环为什么放在浏览器
服务端入口是 src/routes/api/chat/+server.ts。它接收页面消息,调用模型,再把响应流返回页面。核心调用如下:
  const result = streamText({
    model: anthropic('claude-haiku-5-5'), // 服务端选择模型,而不是页面
    system: `You keep the user's task list. Today is ${new Date().toDateString()}.`,
    messages: toModelMessages(request.messages),
    abortSignal: req.signal,
    ...(request.tools?.length
      ? { tools: toToolSet(request.tools), toolChoice: toToolChoice(request.toolChoice) ?? 'auto' }
      : {}),
  });
需要看清 model 和 toToolSet(request.tools) 两处。前者由服务端固定,页面即使请求更昂贵的模型,也不会改变这里的选择;后者只把工具声明交给模型,不附带 execute 执行函数。
几个适配函数承担了协议转换:toModelMessages 转换消息,toToolSet 转换工具声明,toToolChoice 转换工具选择配置,fullStreamToAparteEvents 转换响应事件。最终通过 NDJSON 返回,即每行一个 JSON 对象,响应类型是 application/x-ndjson。
页面用 AparteBackendTransport({ endpoint: '/api/chat' }) 发送请求。完整循环由页面驱动:请求一次模型,等待审批,执行工具,再请求下一次模型。服务端路由每一步只做一次模型调用。
这种安排适合修改页面状态,或携带用户会话调用业务 API。若工具需要直接访问数据库或使用秘密凭据,作者建议把循环迁到 aparté 的 server loop,审批仍留在页面。原文没有展开这部分实现。
密钥配置也有版本差异:SvelteKit 3 在 src/env.ts 中通过 defineEnvVars 声明 ANTHROPIC_API_KEY,从 .env 读取,再由 $app/env/private 导入。SvelteKit 2 则跳过声明文件,使用 $env/static/private。
此外,路由把供应商错误留在服务端日志,只向浏览器返回 The model call failed.。作者给出的理由是:供应商报错可能包含部分密钥。
工具卡片和流式 Markdown,决定用户能否看懂过程
工具审批要有用,用户就得看得懂自己正在批准什么。
aparté 默认把工具调用显示成一行,参数可以展开查看。通过 <AparteToolUI name="add_task">,开发者可以用自己的 TaskCard.svelte 替换这一行。
卡片读取 tool.input 展示标题和日期,读取 tool.status 展示进度。同一次调用的组件会原地更新,状态从 awaiting-approval 变为 resolved 或 rejected,对应等待批准、已添加和未添加。模型参数还在流式到达时,组件也会跟着更新。
这里有个细节:示例卡片展示的是调用参数;虽然工具返回了 structuredContent,这张卡片并没有读取它。接入真实接口后,如果后端会修正日期或补充任务编号,就需要进一步区分「模型申请的数据」和「实际执行的结果」。
Markdown 则由 setupMarkedStreamingProvider() 配置。marked 负责解析,Vercel 的 remend 临时补齐尚未闭合的语法,让未完成的加粗、表格也能逐步显示。
页面生命周期通过 createAparteClient() 管理:挂载时启动聊天循环,销毁时停止。作者称页面仍支持服务端渲染和水合,不会出现不匹配。配置导入放在 <script module>,避免每次页面挂载都重复执行模块初始化。SvelteKit 3 使用 #lib 别名,SvelteKit 2 对应改为 $lib。
我的判断
这套方案最有价值的地方,是把「生成建议」和「产生副作用」之间的边界做成了明确交互。相比聊天回复一句「已经帮你添加」,工具卡片能把参数、等待状态和执行结果摆出来,用户更容易发现日期理解错误之类的问题。
但审批界面不能代替后端授权。
示例处理函数运行在浏览器,真实业务 API 仍需校验会话、参数和操作权限。String(...) 只是类型转换,不能据此认定输入有效。聊天路由同样如此:原文明确提醒,它默认响应所有能访问的人,必须先检查用户会话。
演示还没有保存会话,刷新就会重来。作者提到可以接 storage adapter,但没有提供实现。内存任务数组也没有展示多人隔离和持久化方案,不能直接作为生产数据层。
证据范围尤其需要看清:作者实际运行时,用的是通过 @ai-sdk/openai-compatible 接入的本地 Gemma,替换了 Claude。因此,anthropic('claude-haiku-5-5') 这一行并未实测。无密钥演示则使用脚本模型,它能展示审批、卡片和流式 Markdown,但不理解用户请求。
原文也没有给出 aparté 与自建组件在体积、性能或维护成本上的对照。「约 150 行」说明示例紧凑,不能直接证明团队接入成本更低。我的取舍是:已有聊天 UI 时,优先参考它的审批流程;需要快速补齐 Svelte 聊天界面时,再评估引入整套组件的收益。
能拿来做什么
- 给现有 AI 编程或业务助手增加写操作前,先列清工具名称、参数和副作用,并把用户确认放到真正执行之前,让用户能检查模型准备做什么。
- 在 SvelteKit 中接模型时,把密钥和模型选择放进服务端路由;接业务 API 时,再分别补齐聊天入口与工具接口的会话校验。
- 做任务类交互时,让卡片持续展示待批准、完成和拒绝状态;如果接口会修改输入,就用实际返回的数据展示最终结果。
- 按工具需要的权限决定循环位置:页面状态操作可留在浏览器,涉及数据库或秘密凭据时评估 server loop,并分别验证模型接入、审批和拒绝后的重试流程。