浏览器跑小模型:WebGPU 实测与缓存
社区开发者将 Spark-X2.6-1.7B 转为 4 位 ONNX,在浏览器通过 WebGPU 推理,首次下载约 1.21 GB。作者在 RTX 3090 Ti 上测得约 104—109 tokens/s,并展示首 token 延迟随输入增长及 GPU KV 缓存复用的实现细节。
AI 深度解读
浏览器里的本地 AI,已经有人跑到了每秒约 105 个 token。社区开发者 Mohd Mahmodi 把 Spark-X2.6-1.7B 转成了 4-bit ONNX 构建,通过 WebGPU 在浏览器中推理,首次下载约 1.21 GB,后续访问使用浏览器缓存。
这份报告值得看的,是模型转换、GPU 缓存和多轮对话怎样组合成一个可用原型。不过,速度来自 Windows 11、桌面 Chrome 和 NVIDIA RTX 3090 Ti,不能直接当成普通笔记本的体验预告。
每秒上百个 token,为什么仍可能等上几秒
作者测试了 28、1k、4k、8k、16k tokens 五种提示长度,对应生成速度分别是 108、104、107、109、107 tokens/s。输入变长后,持续输出的速度基本稳定。
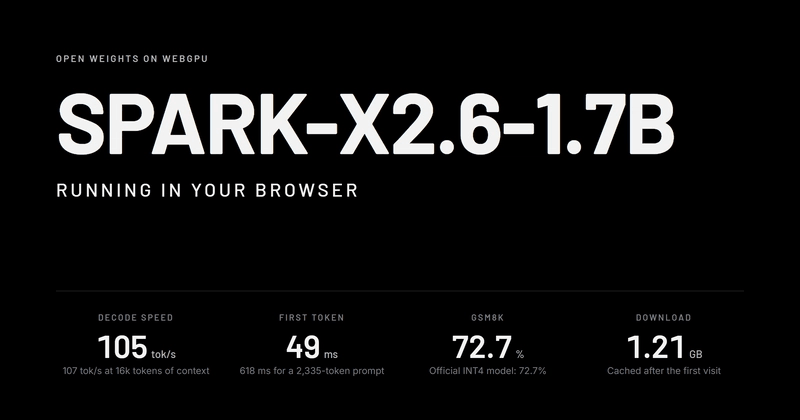
但首 token 延迟从 28-token 提示下的 49 ms,增加到了 16k tokens 下的 5.9 秒。前者是模型开始回答前的等待时间,后者的 tokens/s 是开始回答之后的输出速度,两者衡量不同阶段。
长对话输出快,不代表长文档提交后立刻有响应。
对前端交互来说,这个区别很实际。用户提交一段长内容,即使之后文字流出得很快,前面几秒仍然需要明确的等待反馈。拿 49 ms 宣传长文档体验,就超出了这次测试的证据范围。
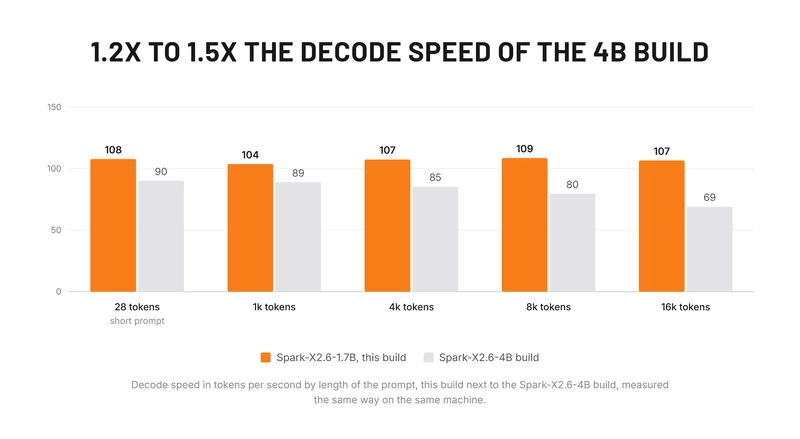
这些数据是作者的测量,不是 SparkLLM 新跑的一轮基准测试;测试时一次只处理一个请求。
真正值得借鉴的是加载器和缓存处理
这个方案不只是把权重下载到网页。仓库提供了 JavaScript loader、thinking 控制、多轮聊天和工具调用解析。
其中一个关键实现是:加载器把 KV cache 留在 GPU 上,后续聊天复用已经缓存的前缀。KV cache 可以理解为模型对已处理上下文保存的中间结果,复用它,能够减少重复计算历史内容的工作。
首次约 1.21 GB 的下载解决的是模型文件如何到达浏览器;KV cache 解决的是对话过程中如何利用已算过的内容。两者不要混为一谈。前者会影响首次访问成本,后者影响多轮交互的计算过程。
质量验证也有边界。作者在关闭 thinking、使用相同提示和贪心解码的条件下,报告浏览器构建在有限检查中达到了官方 INT4 的分数,而不是 BF16 模型的水平。工具调用能力的差距仍然存在。
原文没有列出这些质量检查的具体项目和分数,因此无法进一步判断它适合哪些任务,更不能据此认定转换前后输出完全相同。另一个实测结果是连续运行 30 分钟、完成 877 次生成且没有报错,这能说明该环境下的短时稳定性,覆盖不了长期运行和复杂并发。
我的判断
我更看重它提供了一个可参考的浏览器推理实现:模型加载、GPU 缓存、多轮对话和工具调用解析都有落点。对于想做本地助手的前端开发者,它比孤立的速度数字更有参考价值。
不过,RTX 3090 Ti 的测试结果离普遍可用还有距离。作者只验证了 Windows 11、Chrome、RTX 3090 Ti;手机、集成显卡和其他平台都没有得到验证。原文建议使用桌面 Chrome 或 Edge 试用,但不能把试用建议等同于已完成兼容性测试。
还有一个直接影响产品设计的限制:同一个 Chrome 实例打开两个标签页,可能耗尽 D3D12 descriptor heaps,也就是图形接口用于管理资源描述信息的存储空间。应用也不支持 CPU/WASM,不能假设 WebGPU 不可用时会自动降级运行。
与服务端推理相比,这条路线把模型下载和运行资源交给了用户设备。原文没有给出两种方案的成本、质量或延迟对照,现阶段更适合把它视为实现参考,而不是替换服务端方案的结论。
以上判断对应原文注明的源码快照:1a2cedace485d8bdae557729adaa8f34ea05eed1。
能拿来做什么
- 做浏览器本地助手原型时,可以参考 JavaScript loader 的 GPU KV cache 和前缀复用方式,重点观察连续多轮聊天的表现。
- 做性能验证时,分别记录首 token 延迟和持续生成速度,并覆盖短提示与长输入,避免用一个 tokens/s 数字概括体验。
- 接入工具调用前,先用自己的实际任务检查参数解析与调用正确率;原文明确保留了能力差距,不能用文本生成速度代替功能验证。
- 首轮试用从单标签页开始,把约 1.21 GB 下载、目标显卡兼容性和缺少 CPU/WASM 降级支持纳入产品评估。