Linger 给 16 GB Mac 配候选模型
Linger 的安装器会按硬件与可用内存推荐配置,为 16 GB Mac 列出量化的 Spark-X2.6-4B,两路会话共享 64K 上下文。现有双路吞吐数据来自 24 GB Mac,16 GB 实机尚待验收。
AI 深度解读
Linger 把本地 AI 助手的模型选择放进了安装流程。安装器先看硬件和当前可用内存,再给出配置建议。对于 16 GB Mac,项目列出的候选模型是 Spark-X2.6-4B Q4_K_M。
这份方案值得读的地方,是它把硬件推荐、跑分条件和真机验收进度都写了出来。想在自己的 Mac 上跑本地助手,或者给应用加一条本地推理路径,可以用它判断配置表里的数字到底能回答什么问题。
16 GB Mac 的两个会话怎么分上下文?
simplexai-labs 维护的 Linger 是一个个人助手项目。它的硬件指南为 16 GB Mac 规划了两个推理槽位,共用一个 64K 上下文池。槽位可以理解成处理并发会话的位置。两个会话的上下文都计入同一份预算,其中一个会话读入很长的材料,另一个会话能分到的空间就会变少。
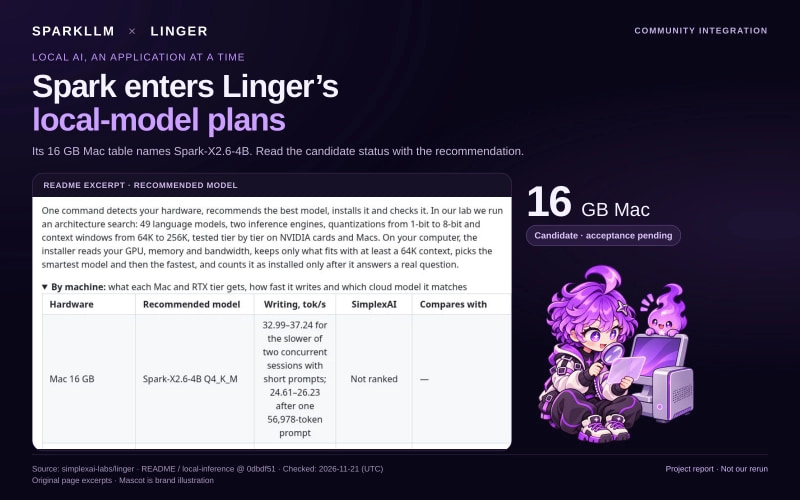
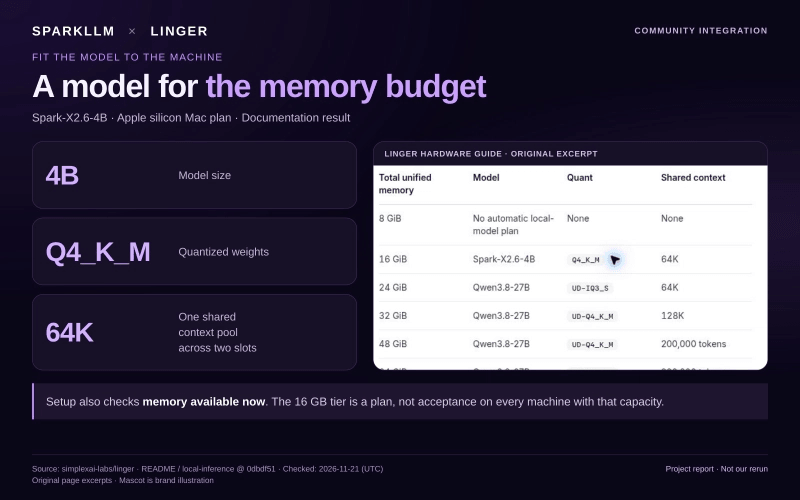
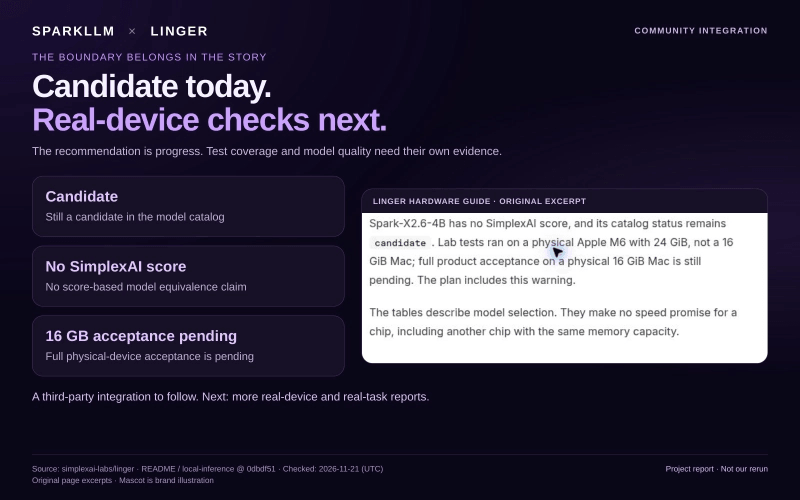
安装器同时看硬件和当前可用内存,这对开发机尤其实际。同一台 Mac 开着 IDE 和浏览器时,留给本地模型的内存可能和刚开机时差不少。项目把这档配置标为候选,实体 16 GiB Mac 上的完整产品验收仍待完成。Windows 的 8/12 GiB GPU 方案也把 Spark 列为候选后备模型,同样在等真机验收。已安装的桌面包还可能带着较早版本的工具包。
两组速度数据是在哪台机器上跑出来的?
Linger 仓库报告用的是一台 24 GB 的 Apple M6 Mac mini。推理环境为 llama.cpp b12167 Metal,KV 缓存使用 q8_0,两个槽位共享 64K 上下文池,内存提示词缓存(RAM prompt cache)关闭。KV 缓存保存模型处理过的上下文所需的中间状态,它的精度也是这组测试条件的一部分。
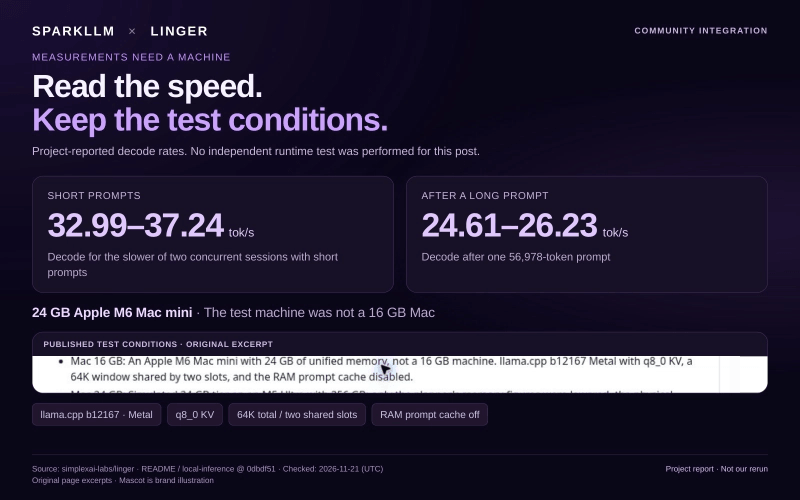
两个短提示词会话并发时,较慢的一路测得 32.99–37.24 tokens/s。在输入 56,978 token 的提示词后,报告记录的速度是 24.61–26.23 tokens/s。后一组数字描述的是长输入之后的生成速度,光看这个数字算不出用户等首个 token 等了多久。原文转述了仓库报告,作者没有另行复测。
我的判断
把模型建议放进安装器,比只在 README 里给一张固定配置表多考虑了一件事,即用户安装时机器还剩多少内存。至于它能省掉多少配置时间、减少多少失败,原文没给对照数据,目前只能当作工程经验。
24 GB 机器上的实测提供了并发和长输入场景的速度参考。要判断 16 GB Mac 上的助手好不好用,还得看实体机器能否跑完真实任务。例如,让助手读一批项目文件、调用工具,再接着已有会话完成修改。模型生成得多快只是其中一环,工具调用和记忆能否接上也会影响结果。
能拿来做什么
- 给本地助手做安装流程时,把设备规格和安装时的可用内存都纳入配置判断。界面直接写明「两个会话共享 64K」,让用户知道并发任务会怎么占用上下文。
- 试跑本地编程助手时,分别测两个短请求并发和一次长输入任务。除了生成速度,也记下首字等待时间和任务是否跑完,方便定位卡在哪一步。
- 分享试跑结果时,一并写上应用与工具包版本、芯片、可用内存、量化配置、上下文设置和任务结果。桌面包可能内置较早的工具包,复现时以实际运行的版本为准。