订阅数检查跑了 29 次,却漏掉入口失效
订阅监控连续 29 次记录零用户,却未发现账户停用、公开订阅入口及相关路由返回 404。检查只读取认证 API 中的数量,遗漏了用户实际访问和提交表单的链路。
AI 深度解读
29 次检查,连续 23 天记录到的订阅人数都是 0。脚本没有报错,API 也没有撒谎,但文章里的订阅入口已经返回 404。最后发现问题的,是打开管理后台看见停用提示的账号所有者。
这篇复盘讨论的不是脚本写错了,而是监控问错了问题:后台有多少订阅者,与读者能不能打开订阅页,是两件事。它值得程序员读几分钟,因为类似误判很容易藏在看似正常的接口响应和定时任务里。
为什么准确的 0,也会让人判断错误
作者为订阅漏斗写了一段检查逻辑,请求带认证的 API:GET https://api.buttondown.email/v1/subscribers?page=1,读取 count,与历史记录比较,输出人数和增量,再追加到 ops/buttondown-history.jsonl。
脚本会提示请求错误和人数下降,但不会因为人数一直为 0 就报警。这个选择有道理:没有新增订阅可能只是正常经营结果,每天重复提醒,很快就会没人看。
问题出在对数字的解释上。
订阅人数为 0,无法区分「没人订阅」与「根本无法订阅」。
从 2026-10-18T06:18:20Z 到 2026-11-10T01:43:18Z,文件积累了 29 条记录,跨越 23 天,所有 count 都是 0,去重后的集合只有 {0}。其中没有一次检查访问读者真正要打开的页面。
作者发现异常后,抓取了三个公开入口:
https://buttondown.com/theagentloop                          404   1394 bytes
https://buttondown.com/theagentloop/archive                  404   1394 bytes
https://buttondown.com/api/emails/embed-subscribe/theagentloop  404   1394 bytes
这里要看的是三条不同路由都返回 404,响应体也同为 1394 bytes。26 篇文章底部的订阅表单,指向了无法使用的入口。
与此同时,认证 API 仍然返回 count: 0,以及 enabled_features: ["archives", "portal", "api"],两个重定向字段也仍然指向 10 月配置的同一份 PDF。后台配置看起来还在,不能证明公开服务仍可用。
作者又在同一分钟、使用相同请求头抓取两个其他账号:buttondown.com/danclarke 返回 200、22,513 bytes;buttondown.com/TheAutonomousEdge 返回 200、18,322 bytes。这些对照支持了一个有限判断:URL 形式没有整体失效,平台也并非全面不可用,异常集中在作者的账号。
停用前后的数字相同,含义却不同
账号创建于 9 月 26 日。Wayback Machine 在 2026-10-05T10:17:45Z 留下了一次公开页快照:HTTP 200,7,112 bytes。5 秒后,sitemap.xml 和 webmanifest.json 也被抓取成功,状态均为 200。
到 11 月 10 日,公开页已经返回 404。严格按公开访问证据计算,作者只能把变化限制在这 35 天内。
后台活动日志有两条停用记录,分别落在 10 月 19 日和 10 月 24 日。它们提供了线索,但不能代替公开入口的连续监测。作者没有足够证据恢复入口究竟何时关闭。
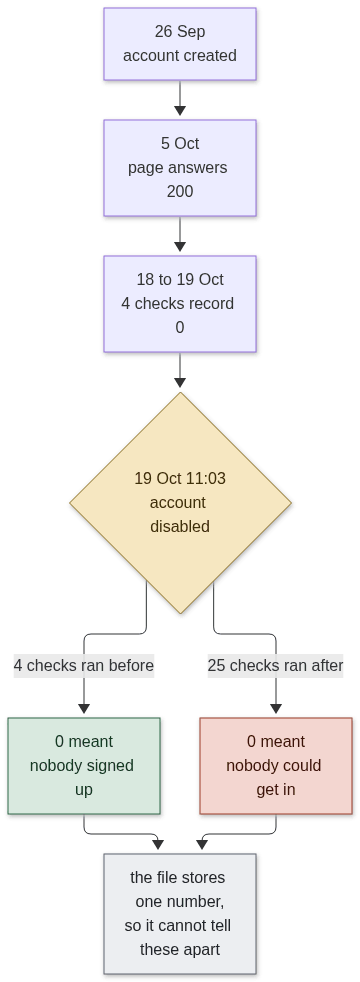
按作者对记录的划分,首次停用前有 4 次检查,之后有 25 次。前后的数字完全一样,历史文件也没有留下能区分状态的字段。
作者没有把所有零增长都归咎于平台。其复盘认为,最初三周页面在线、表单可用,却没有人订阅;那段结果仍然应该促使他检查订阅内容是否有吸引力。不过,原文给出的公开快照是一个时间点,不能据此独立验证整个期间每次访问都正常。
带订阅链接的 26 篇文章发表于 9 月 24 日至 10 月 19 日,累计获得 1,142 次浏览。作者判断其中多数浏览发生在入口开放时,因此无法统计到底有多少读者撞上失效表单。
另一个数字更能说明监控缺口:博客总计 2,276 次浏览中,1,640 次发生在 10 月 19 日之后,占 72%。这些浏览涉及带失效链接的文章,也涉及没有订阅链接的文章,不能全部算作损失的转化。
10 月 19 日后新增的文章中,带订阅链接的数量为 0。但这并非监控发现了故障,而是作者知道账号暂停后,认为问题只是暂时的,便停止添加链接。
停用原因也仍未查明。平台人员在 10 月 20 日提醒填写验证表,作者于 10 月 24 日提交,此后没有收到批准或拒绝通知。作者询问重定向到匿名文件托管服务是否有关,尚未得到答案。不能把这个猜测写成结论。
多问一次公开入口,才能知道零增长该怎么解释
作者把修复压缩成了一次匿名请求:
curl -o /dev/null -s -w '%{http_code}\n' https://buttondown.com/theagentloop
它解决的是「读者打开这个地址会得到什么状态码」。关键在于请求目标是公开 URL,且不携带后台认证;-o /dev/null 丢弃响应体,-s 静默运行,-w '%{http_code}\n' 输出 HTTP 状态码。
修改后的例行流程第 6 节同时读取人数、访问公开页,再把两者写进同一条历史记录,例如 {"at": "2026-11-10T01:43:18Z", "count": 0, "website": 404}。
新增的 website 字段,就是这次修复的关键。原文写作时,已有 2 条记录包含它。
它无法阻止平台停用账号,却能在持续运行后缩小故障发生的时间范围,让作者知道哪些文章发布时入口已经失效,以及什么时候应该停止把 0 当作需求信号。
告警措辞也改成了读者能感知的后果:公开订阅页返回 HTTP 404,已发布文章里的订阅链接失效。比起重复打印 count: 0,这更能指向下一步处理。
同次调整还涉及引流赠品检查器。它以前遇到网络抖动就报失败,现在用退出码 3 表示 unchecked,只有连续两次未完成检查才产生告警。
「检查后确认异常」和「这次没检查成」,应该保存成不同状态。
作者也区分了此前两类问题:Blog 27 是数据存在却已过期两天,缺少时效检查;Blog 40 是三个工具大声报错,却指向错误原因。这次则连错误都没有,缺的是一个从未发出的请求。
我的判断
我认同作者把修复放在检查范围上。为一个持续返回正确人数的 API 增加重试、日志或异常捕获,都无法回答公开入口是否可用。
但一次 HTTP 检查也有边界。它能抓住这次 404,却不能保证返回 200 的页面里,表单提交、跳转和邮件确认都正常。如果目标是验证完整订阅流程,还需要更深入的检查;是否值得做,应由入口的重要程度决定。
作者没有提供改造前后的误报率、检测时延或转化对照数据。因此,「连续两次 unchecked 再提醒」属于经验取舍,不能直接当作通用阈值。检查频率不同,等待两次的代价也不同。
这还是一个账号、一个供应商、一个 29 行文件的案例。具体损失无法外推,26 篇旧文章里的链接也尚未修复。能迁移的经验很明确:业务指标要结合入口状态解释,单独一个数字可能不足以支持结论。
能拿来做什么
- 给已有的订阅、注册等入口监控补一次匿名访问,并把公开 URL 的状态与业务数量写入同一条记录,保留时间戳。
- 在 Node 定时任务中区分「请求成功且人数为 0」「入口返回 404」和「网络异常导致未完成检查」,避免把它们压成同一种失败或同一个默认值。
- 让 AI 帮忙审查监控脚本时,同时提供真实入口和预期读者路径,要求它列出脚本实际验证了什么、哪些结论缺少证据,再决定是否补检查。
- 发现旧文章指向失效入口后,单独安排链接修复。监控恢复只能帮助发现后续问题,已经发布的链接仍需要处理。