64GB 跑 284B 模型,先看测试条件
文章审视 llama-modchip 的低内存运行宣传,区分 MoE 模型的总参数与每个 token 的激活参数。摘录列出模型约 2843 亿总参数、132 亿激活参数,并说明项目涉及底层内核补丁和量化转换。
AI 深度解读
把 284B 参数的 DeepSeek 塞进 64GB 内存,还不用 GPU,听起来像是本地 AI 编程的一次大突破。作者检查 llama-modchip 仓库后发现,文件大小和带宽账基本算得通,但「能装下」「跑得快」「质量没掉」是三件需要分别验证的事。
这篇最有用的地方,是教程序员拆解一张性能宣传单:速度用了什么模式,长上下文测的是容量还是体验,所谓无损又是在和谁比较。作者没有下载模型做推理,实际运行的只有硬件检查脚本。这个证据边界要先记住。
284B 能塞进内存,为什么不等于跑出了 284B 的速度
DeepSeek-V4-Flash 是混合专家模型(MoE):总参数有 284.33B,每个 token 实际激活约 13.17B。路由器会逐层挑选专家参与计算,不会每次跑完整个模型。
但下一个 token 可能用到哪个专家,不能提前确定。所有专家仍需要待在足够快的存储里。因此,总参数决定内存压力,激活参数影响生成速度。把部分专家留在 SSD 上,会面临反复读盘,也就是仓库所说的 page-cache thrashing。
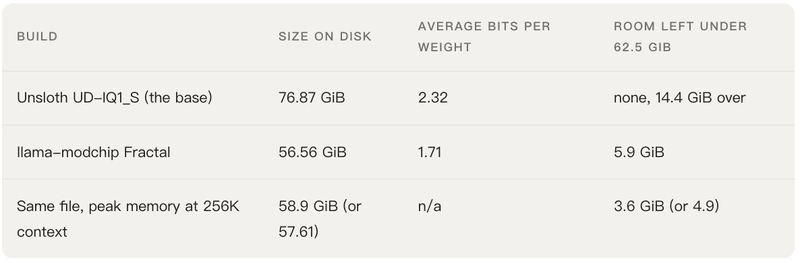
llama-modchip 是修改过的 llama.cpp,加上一组量化转换器和运行工具。作者检查的是 v2.4.0、commit a9635a5,其声明把模型从 76.87 GiB 压到 56.56 GiB,平均每个权重 1.71 bit。这个除法成立,原文件平均则约为 2.32 bit。
压缩并非平均下刀。嵌入、首个稠密层、43 个共享专家和部分注意力投影保留 Q4_K、Q5_K 或 F32;部分原本 8-bit 的注意力投影转成 3.75-bit 的 Fractal-64;每层 256 个路由专家大多压到 IQ1_S,即 1.5625 bit,敏感层保留 IQ2_XXS 的 2.06 bit 或 IQ1_M 的 1.75 bit。
真正需要验证的,是这些低比特专家还保留了多少能力。
内存也只是勉强够用。README 按 64GB Linux 机器可用 62.5 GiB 计算,256K 上下文峰值却分别出现 57.61 GiB 和 58.9 GiB 两个数。按后者计算,只剩约 3.6 GiB 余量,桌面和浏览器都会继续挤占空间。
速度声明至少没有超出带宽上限。文档给出每个 token 读取 3.20 GB 活跃权重,剪枝后为 2.85 GB;双通道 DDR5 按约 75 GB/s 算,纯搬权重的理论上限约为 23 tok/s。默认生成的 9.06–9.95 tok/s 在这个范围内。
算得通,只能排除明显不合理,不能代替实测。
256K 是装得下,9.1–14.7 tok/s 则混合了不同条件
仓库在 AMD Ryzen 9 9955HX、Zen 5、16 核、64GB、无 GPU 上报告 prefill 为 44.4 tok/s,decode 为 9.1–14.7 tok/s。前者是读提示词,后者是逐个生成 token。
问题在于,这些数字没有共享同一组测试条件。
默认每层运行六个路由专家时,decode 为 9.06–9.95 tok/s。11.5–14.7 tok/s 需要 Stockfish-PVS 推测解码:先由草稿器猜多个 token,再交给大模型批量验证。重复代码、JSON 容易猜中,新写的自然语言未必有同样收益。
Top-5、Top-4 模式通过少用专家跑到 9.68–10.74 tok/s,但会改变输出。仓库报告它们相对默认模式的 KL 散度为 0.0042–0.0694 nats,这个指标描述输出概率分布偏移,不能直接当成业务准确率。
44.4 tok/s 的输入速度来自 63–580 token 的提示,以及六轮增长到 2,418 token 的 agent 对话;这六轮里,速度从 44.36 降到 38.44 tok/s。没有速度表测试到 256K。
256K 在这里首先是内存容量声明,不是长文处理速度或检索质量承诺。
缓存能这么小,主要来自 DeepSeek 的设计和上游 llama.cpp 实现:近期 token 使用滑动窗口,旧历史按层采用 4:1、128:1 压缩,对应 DSV4_CSA_RATIO = 4 和 DSV4_HCA_RATIO = 128。作者没下载 GGUF,无法确认每层的实际配置,也没找到该模型的长上下文质量测试。
启动参数 -c 262144 能分配这么长的上下文,不代表输入同样长度的文档很快。按短输入速度外推,读完 262,144 token 约需 98–114 分钟,而且这还是假设深度增加后速度不再下降。README 的快速启动实际使用 -c 32768。
生成 500 token,按 9.06 tok/s 约需 55 秒。仓库提供 13.1–32.6 ms 的 slot restore,用于恢复已保存缓存,避免每轮重读相同前缀。对通过 ./modchip claude 接入本地服务的 Claude Code,这往往比最高输出速度更影响使用感受。
检查脚本给出 Tier A,也不能证明模型能跑
作者唯一亲自运行的是 scripts/check_cpu_readiness.py。他们先读了这份 590 行、仅用标准库的脚本,确认没有联网和写文件行为,再用 python3 -I 隔离运行。
测试机器是 24GB 的 Apple M4 Mac mini,4 个性能核、6 个能效核,系统为 macOS 15.6.1,Python 为 3.9.6。四次带宽结果为 81.2、98.6、95.1、96.0 GB/s,预测生成速度分别为 20.6、24.6、23.8、24.0 tok/s,却全部得到 Tier A 的生产可用判断。
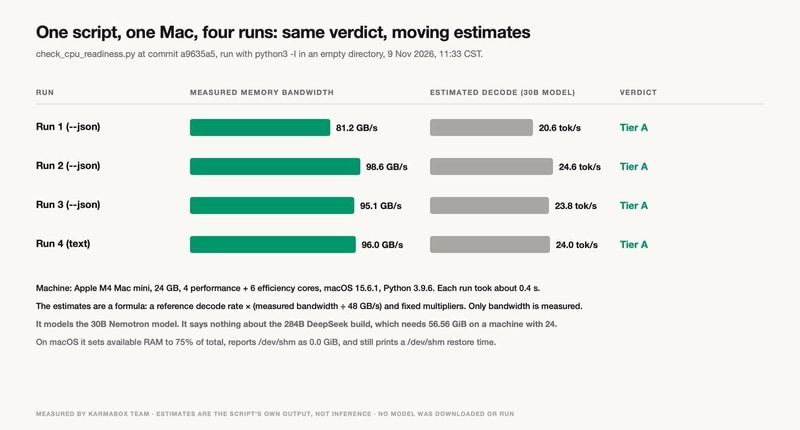
脚本评估的是 30B Nemotron,不是需要 56.56 GiB 的 DeepSeek。它实测的只有带宽,生成速度来自作者 Zen 5 参考值,再按带宽相对 48 GB/s 的比例、SIMD 和缓存系数估算。同机 Nemotron 的 14.35 GiB、25–60.4 tok/s,也不能挪给 DeepSeek 使用。
平台适配还有漏洞:macOS 可用内存被固定算成总量的 75%,即 18.0 GiB;不存在 /dev/shm,仍预测从那里恢复需 9.5 ms;推荐命令使用 Linux 的 taskset 和 -t 10,把能效核也计入线程数。
文件兼容性同样不能只看结论。README 称自定义格式为 type ID 40,但仓库锁定的上游 commit d2f8305 中,定义实际如下:
        GGML_TYPE_MXFP4   = 39, // MXFP4 (1 block)
        GGML_TYPE_NVFP4   = 40, // NVFP4 (4 blocks, E4M3 scale)
        GGML_TYPE_Q1_0    = 41,
        GGML_TYPE_Q2_0    = 42,
        GGML_TYPE_COUNT   = 43,
要看的是 GGML_TYPE_Q2_0 = 42:补丁没有修改这个枚举,却把同名结构从每 64 个权重 18 字节改成 30 字节,即从 2.25 bit 改为 3.75 bit。
因此,普通 llama.cpp、Ollama、LM Studio 无法正确读取这些文件的提醒有道理,具体错误却未必是「unknown tensor type 40」。作者进一步根据差异推断,修改后的程序也可能误读原版 Q2_0 文件。另有用户在老 Xeon 上遇到张量形状错误和 Illegal instruction,后者被追到预编译程序需要 AVX-512。
我的判断
我认可作者把容量、速度、质量拆开检查的做法。相比只看总参数或最高 tok/s,这更接近采购硬件、选择本地编程模型时真正需要的信息。
但目前最缺的仍是质量对照。仓库的 bit-exact 和 1.00000 logit cosine similarity,比较的是同一 checkpoint 在修改前后运行时的结果,能说明优化内核计算一致,不能证明压缩到 1.71 bit 没损失能力。
所谓 100/100 质量门槛也来自 30B Nemotron,其中 20 分属于速度与内存;其余测试包含五次工具调用、三项编程任务和两项针尖检索,覆盖面有限。
基座格式还存在文档冲突:README 写 Unsloth UD-IQ1_S,ARCHITECTURE.md 写 IQ2_XXS。作者根据文件大小推测前者更可能正确,但仓库尚未把口径说清。
所以,现在可以把它视为一个值得继续验证的 CPU 推理方案。若要判断它是否优于普通 llama.cpp 或更小的本地模型,现有材料不够:作者没做推理复测,也没有该 DeepSeek 文件的质量对照。原文末尾提供的其他用户体验同样零散,不能据此得出普遍结论。
能拿来做什么
- 准备下载前,先核对量化格式、峰值内存、CPU 指令集和专用运行时版本,并用
gguf-dump查看张量类型。硬件评级只能作为估算入口。 - 给日常 AI 编程任务做测试时,分别记录读取项目上下文的等待时间和生成答案的时间,再比较默认六专家、推测解码及 Top-4 模式,避免只挑最高 tok/s。
- 在自己的前端或 Node 仓库中,用相同问题比较代码修改、工具调用和测试通过情况。当前缺少的是低比特版本是否仍能完成任务的证据。
- 长会话先从快速启动的
-c 32768评估,并测试缓存恢复流程。只有确实需要更长历史时,再验证 256K 的内存、等待时间和远距离信息检索能力。