AI 建站接入 Supabase,先查行级权限
文章援引调查称,24,664 个 Lovable 站点在无需登录时就向浏览器返回数据库记录,问题根源被归为行级安全策略不足。内容面向使用 Lovable 或其他 AI 工具连接 Supabase 的开发者,提供十分钟自查。
AI 深度解读
24,664 个 Lovable 站点,在没有登录的情况下就向浏览器返回了 Supabase 数据库记录。原文给出的解释很直接:这些应用的行级安全规则不足,页面能正常运行,却没有把数据访问权限关好。
对用 AI 搭建应用的开发者,这篇文章最有用的是一套约 10 分钟的自查路径:用未登录身份请求自己的接口,看看私人数据是否真的受保护。产品更新、页面登录框和扫描结果,都不能代替这一步。
24,664 个站点可读,不能直接算成泄露率
据原文转述,德国安全公司 Crissy Field 与 Handelsblatt 合作,研究了 Common Crawl 归档中的 Lovable 应用。Handelsblatt 在 2026 年 11 月 2 日率先报道,11 月 14 日相关报告又在 Hacker News 获得了接近 700 点热度。
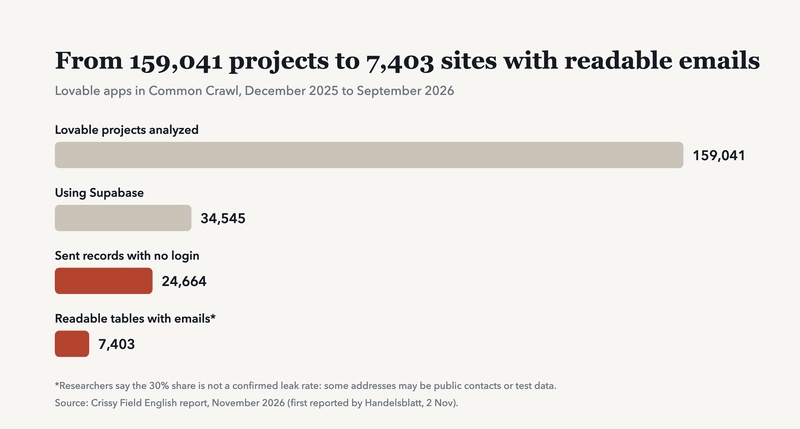
研究分析了 159,041 个 Lovable 项目,其中 34,545 个使用 Supabase,24,664 个会在页面加载时向未登录浏览器返回数据库记录,7,403 个存在包含邮箱地址的可读表。
报告列出的数据包括:某服务商超过 1,000 条护照记录、某生活方式论坛超过 200,000 条聊天消息,以及包含电话号码和地址的票务、餐饮订单。
但研究者也给出了边界。7,403 占 24,664 的约 30%,不能当成已确认的数据泄露率,因为邮箱可能是公开联系方式,也可能是测试数据。他们同样无法判断这些数据是否曾被滥用。
因此,能确认的是「未登录请求能读到记录」。记录是否敏感、是否属于真实用户、是否已被第三方获取,还需要分别核实。
前端公开密钥没问题,权限规则缺失才危险
Supabase 支持浏览器直接访问数据库 API,因此前端会携带公开密钥。原文引用官方文档说明,publishable key 可以公开。
真正决定用户能读哪些记录的是行级安全(Row Level Security,RLS):数据库收到请求后,根据规则判断当前身份能访问哪些行。例如,订单表可以允许用户读取自己的订单,同时拒绝读取其他人的订单。
这里还有一个权限前提:暴露在 API 中的 schema,其表没有启用 RLS 时,拥有相应授权的角色就可以读写。不能脱离表授权,笼统理解成所有未启用 RLS 的表都必然向所有人开放;但前端使用的匿名角色一旦已经获得权限,公开密钥就足以发起请求。
页面要求登录,不等于数据库接口要求登录。
AI 搭建工具容易让开发者漏掉这一层:描述功能、生成表、页面成功展示数据,整个流程看起来已经完成。但「查询成功」验证的是功能,无法证明访问权限正确。
原文还提醒,Lovable 和 Supabase 已推出改动,但不能据此认定已上线应用的旧表得到修复。尤其是 11 月之前上线的项目,仍应逐个检查。文章没有完整展开这些更新的迁移范围,实际判断应落到自己项目的配置和请求结果上。
十分钟检查,先证明陌生人读不到
原文建议只检查自己的项目。第一步进入 Supabase 控制台的 Advisors,再打开 Security Advisor,优先处理「RLS Disabled in Public」错误。
接着在 SQL Editor 查询 pg_tables 中 schemaname = 'public' 的表,检查 rowsecurity;值为 false 的表需要重点核查。只看开关还不够,下一步必须发出真实请求。
下面这条命令用前端同款公开密钥,模拟没有登录的访问者读取已知表:
curl "https://<project_ref>.supabase.co/rest/v1/<table>?select=*&limit=5" \
  -H "apikey: <publishable_or_anon_key>"
要看的是第二行:这里只提供 apikey,没有附带用户登录凭证。如果私人表仍返回记录,其他人也能构造同类请求。也可以用隐私窗口打开线上应用,在 DevTools 中查看 /rest/v1/ 请求。
对于每行都有所属用户的表,原文给出了启用 RLS 并限制读取的示例:
alter table public.your_table enable row level security;

create policy "Users can read their own rows"
on public.your_table for select to authenticated
using ((select auth.uid()) = user_id);
关键在最后一行,它把当前用户的 auth.uid() 与记录的 user_id 对上。这个例子要求表里确实存在对应的归属字段,而且只覆盖 select。insert、update、delete 还需要分别配置匹配策略;敏感数据也不能用 (true) 放行。
文件存储要单独查。原文通过查询 storage.buckets 的 id 和 public 字段识别公开桶,建议护照、发票、合同放进私有桶,通过 signed URLs 提供访问。
密钥也有例外:service role key 会绕过 RLS。如果它出现在前端代码里,应立即轮换,不能指望补一条策略解决。
Lovable 用户还可以运行 Deep scan。原文说直接运行免费,通过聊天要求运行会消耗 credits;官方 FAQ 同时明确,扫描不保证安全。
我的判断
这套检查最有价值的地方,是把验收对象从页面转到了接口。隐藏按钮、跳转登录页,都不足以回答「匿名请求能不能读取私人表」。
不过,「10 分钟」适合作为快速排查的时间预期,不能当成修复承诺。用户独占的数据可以按 user_id 限制,团队共享、组织权限等业务不能直接套用这一个示例。匿名读取失败,也只证明这条访问路径被挡住了,尚未验证写入权限和其他用户之间的隔离。
原文列出的历史案例说明,这类配置问题曾反复出现:CVE-2025-48757 在 2025 年 3 月由 Matt Palmer 向 Lovable 报告,5 月发布,涉及 170 个项目的 303 个端点,占受检 1,645 个项目约 10.3%。2026 年 9 月,UpGuard 又在约 300,000 个具有 Supabase 使用迹象的域名中,发现 16,326 个数据库存在可读表。
这些研究的样本和口径不同,不能拼成漏洞增长曲线。它们也没有提供 AI 生成应用与人工开发应用的对照数据,所以「AI 更容易造成此类问题」仍缺乏这里能直接支持的比较证据。
作者披露自己任职于 Toolbit,文末也推荐了该公司的工具列表。读者可以采用检查方法,但原文没有给出扫描器效果对照,不能据此认定某款工具更可靠。
能拿来做什么
- 给已上线的 Lovable 或 Supabase 项目补一次匿名访问验收,使用前端实际采用的公开密钥,请求明确应当私有的表,并记录返回结果。
- 把 RLS 检查加入 AI 编程验收:每次新增表或修改数据访问逻辑,都核对读取、插入、更新和删除权限。
- 如果应用允许用户查看自己的记录,再用两个不同账号验证数据隔离;原文的匿名测试只能覆盖未登录访问。
- 单独清查上传文件所在的 bucket 和前端密钥,确认敏感文件的访问方式,并处理任何进入浏览器代码的 service role key。