12 张二手 V100 本地推理实测
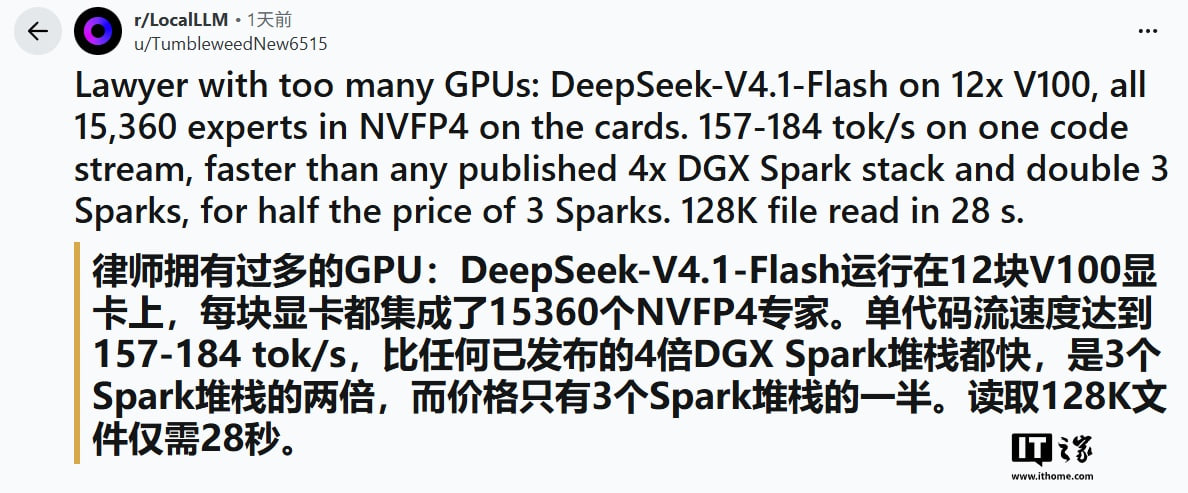
发帖者称,约 9450 美元的集群以 3 段流水线、每段 4 卡张量并行运行 4 位量化的 DeepSeek-V4.1-Flash。单流代码生成最高每秒 184 个词元,普通文本约每秒 83 至 95 个词元,256K 输入的冷启动首词元耗时 58 秒。
AI 深度解读
花 9,450 美元买 12 张二手 V100,就能在本地跑 DeepSeek-V4.1-Flash,单路代码生成达到每秒 157 至 184 个词元。这是 IT之家转述的一位律师的自建服务器案例,亮点是旧卡通过多卡协作获得了较高的推理速度。
但「跑得快」和「值得买」之间,还隔着测试条件、量化质量、耗电与维护。原文甚至对 15,360 这个数字有两种不同解释。对程序员而言,这个案例值得看,采购结论却得缓一缓。
12 张旧卡是怎么一起跑模型的
据报道,Reddit 用户 u/TumbleweedNew6515 于 11 月 20 日发帖,介绍了自己的私人 AI 服务器。核心硬件是 12 张 NVIDIA Tesla V100 SXM2 32GB,通过 NVLink 与 PCIe 协同推理,采购成本约 9,450 美元,报道折合人民币约 63,239 元。
系统采用 PP3 × TP4:把模型计算拆成 3 个流水线阶段,每个阶段再由 4 张卡分担计算。可以理解为三组工位,每组四张卡合作,接力完成一次推理。
运行的模型是 DeepSeek-V4.1-Flash,采用 4-bit NVFP4 量化。量化用更低的数值精度保存权重,目的是减少模型占用,让这些旧卡容纳模型中的专家分片。不过,报道没有提供推理框架、部署命令,也没有交代 V100 上具体如何实现 NVFP4 推理,无法据此复现。
这里还有一处需要直接指出的矛盾:中文正文称「每个专家被压缩至约 15,360 个参数」,但所附英文帖文写的是「全部 15,360 个专家」以 NVFP4 形式放在显卡上。两者分别在说单个专家的参数量和专家总数,不能混用。仅凭这篇报道,无法确认完整的模型结构与存储细节。
每秒 184 个词元,究竟证明了什么
发帖者给出的单路代码生成速度是 157 至 184 tok/s,测试强调单请求、单流。这里的词元(token)是模型处理文本的单位,不能直接当成中文字数或英文单词数。
这组数字描述的是特定条件下的单路生成表现。
作者称,这套服务器比已公开的 4 台 DGX Spark 组合更快,代码生成速度高约 15% 至 45%,普通文本生成也更快。英文帖文还声称,其速度是 3 台 DGX Spark 的两倍,价格约为后者的一半。
这些都是发帖者报告的结果。原文没有给出对照测试的完整配置,也没有列出提示词、输出长度、量化设置或软件版本,暂时无法判断差距有多少来自硬件,有多少来自部署方式。
另一个数据是「128K 文件在 28 秒内读完」。报道没有解释 128K 的计量单位,也没有定义「读完」如何计时,更没展示读取后的问答质量。它可以作为进一步调查的线索,不能直接等同于长文档理解能力。
我的判断
这个案例有价值的地方,是展示了二手硬件、多卡并行和低精度量化组合起来的一种可能性。对于确实需要本地运行模型的人,它提供了一个可研究的方案。
但原文支持的结论,还到不了「V100 集群比 DGX Spark 更划算」。硬件采购价只是成本的一部分:系统最高功耗约 2,100W,噪音较大,报道也明确说不适合普通办公环境。满载持续运行一小时,对应约 2.1 度电,尚未计入额外散热。
与调用托管 API 相比,自建还要承担部署和维护;与购买整机相比,二手多卡方案需要自己解决更多集成问题。原文没有提供长期稳定性、量化前后质量或总使用成本的对照数据,因此性价比结论仍是个案经验。
可以参考它的组装思路,不能照搬它的采购结论。
能拿来做什么
- 如果你想给日常 AI 编程配本地模型,先用真实代码任务验证生成质量,再记录首个词元等待时间和持续生成速度,避免只看最高 tok/s。
- 如果团队准备采购多卡服务器,可以把 PP3 × TP4 当作研究入口,但应先找齐推理框架、启动参数和硬件连接方式;这篇报道还不足以充当部署教程。
- 如果主要用途是读取大型代码文件,应单独验证输入处理耗时和后续回答准确率,不要把「128K、28 秒」直接写进项目性能预期。
- 如果要比较自建与托管 API 的费用,应把电费、散热、噪音处理和维护时间一起计入,并按自己的实际使用量计算。