米哈游 Gamer 用画面与键鼠完成游戏任务
Gamer 以游戏画面为输入、键鼠指令为输出,结合跨游戏预训练与强化学习,在 40 项未见小游戏任务上取得 49.7% 的平均成功率。配套 Streaming-vLLM 在 H200 环境下将端到端延迟从 1306 毫秒降至 65.12 毫秒,但未发布星穹铁道相关训练数据及对应权重。
AI 深度解读
米哈游《崩坏》系列 AI 研发团队公布的 Gamer,尝试让模型只看游戏画面、操作键鼠,自主游玩 3D 和 2D 游戏。它值得关注的地方,是把视觉理解、连续操作和低延迟推理接到了一起。
但「能演示」距离「稳定通关」还有差距:强化学习版本在 40 项此前未接触过的小游戏任务中,平均成功率为 49.7%;《崩坏:星穹铁道》相关训练数据和训练后的模型权重也没有公开。读这则消息,需要把操作机制、测试成绩与开放范围分开看。
只看画面,模型怎么连续操作游戏
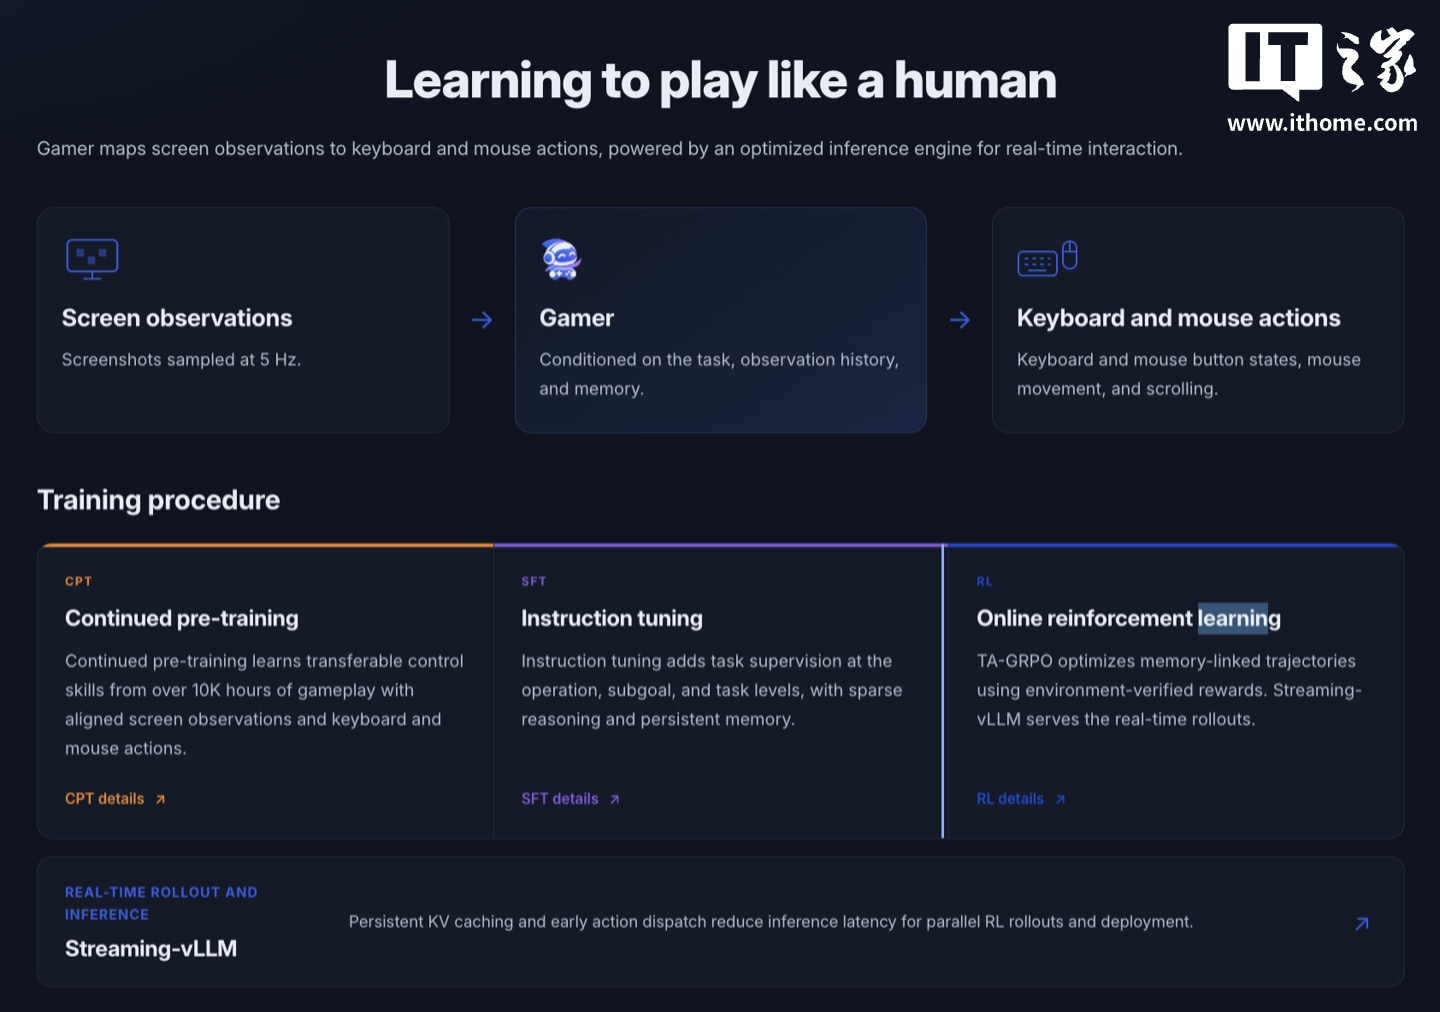
Gamer 被称为视觉语言动作基础模型,即 VLA(Vision-Language-Action)。大白话理解,就是让模型把看到的场景与任务要求转成实际操作,而不只是描述画面。
它无需读取游戏内部数据,也不依赖游戏专用 API。输入端以每秒 5 帧,也就是 5 Hz 的频率采集画面;输出端生成相当于 30 Hz 的原生键盘按键状态和鼠标移动指令,模拟真人使用键鼠。
这里有两个不同的频率:模型接收画面的频率,与生成操作指令的频率。30 Hz 的操作输出,不等于模型每秒观察了 30 次游戏。
这种接口让它有机会跨游戏工作,因为不必为每款游戏接入专用数据接口。但画面中的信息是否足够、快速变化能否及时捕捉,仍然需要具体任务验证。
跑得起来,靠训练也靠推理引擎
长时间执行游戏任务,既考验模型如何利用过去的信息,也考验每次操作能否及时返回。团队采用了几项配套做法:
- 使用超过 1 万小时的跨游戏键鼠操作轨迹,进行持续预训练。
- 结合稀疏思维指令微调和时序感知强化学习,进一步优化模型。
- 开发 Streaming-vLLM 推理引擎,处理长期任务中的内存限制和推理延迟问题。
「稀疏思维」可以先理解为不在每个操作步骤都展开冗长推理;「时序感知」强调操作前后的时间关系。不过,这则报道没有解释具体实现,不能据此判断训练配方如何复现。
推理方面的数据更明确:在 NVIDIA H200 硬件环境下,Streaming-vLLM 将端到端请求延迟从 1306 毫秒降到 65.12 毫秒。
这个成绩有价值,交互任务中的等待会直接影响操作。但请求延迟不等于完整任务耗时,报道也没有给出其他硬件上的表现,不能直接推断普通开发设备能达到同样速度。
49.7% 的成功率,证明到了哪一步
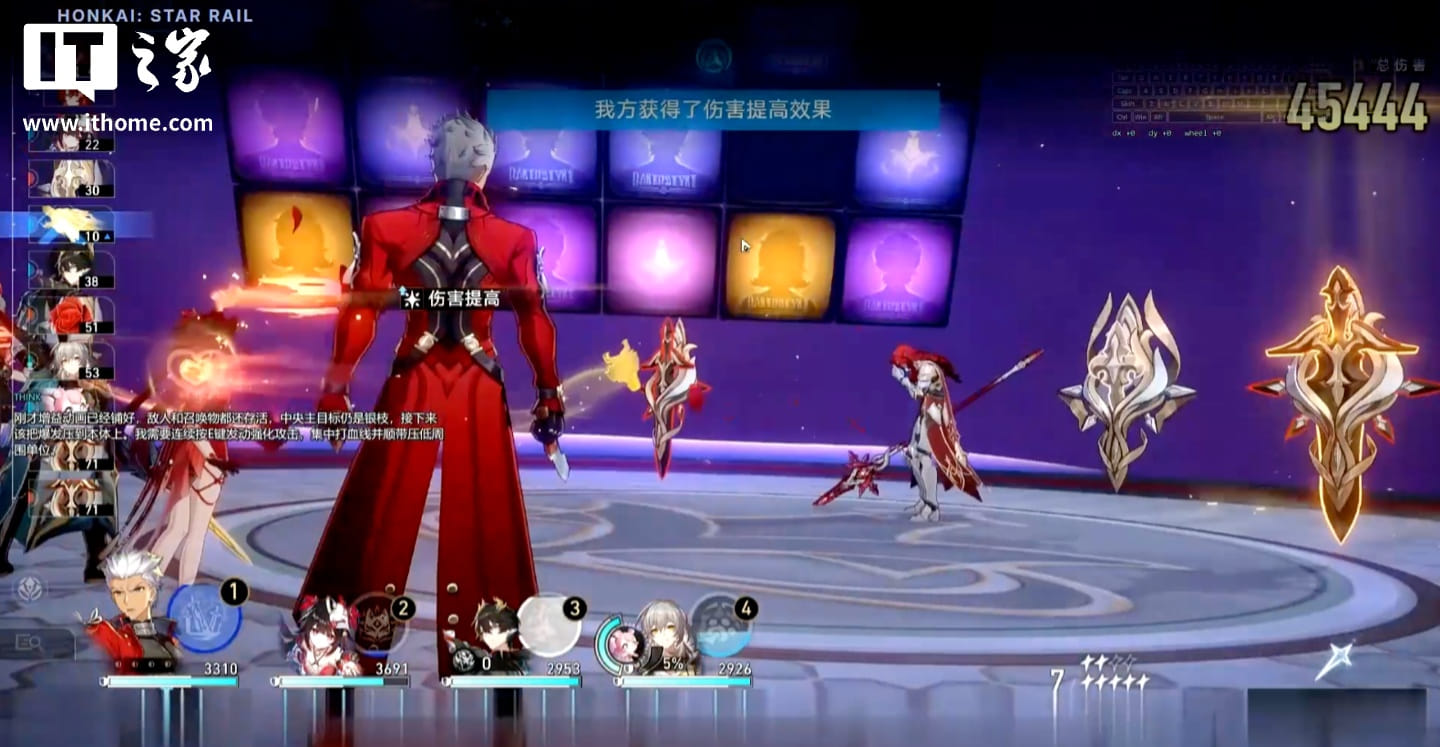
团队展示了 Gamer 在《崩坏:星穹铁道》中执行主线任务、探索场景和完成解谜挑战的实机演示。
量化结果来自另一组描述:经过强化学习训练的 Gamer-RL,在 40 项此前未接触过的小游戏任务中,平均成功率达到 49.7%,优于未经微调的通用模型。
这支持它具备一定的跨任务迁移能力,但不代表它能稳定完成任意游戏。49.7% 是这组小游戏任务的平均成功率,不能当作《崩坏:星穹铁道》的通关率。
报道没有列出对照模型名称、具体成绩、每项任务的尝试次数和成功判定标准。因此,能确认的是这组测试中的表现,优势幅度和结果稳定性还需要更完整的数据。
我的判断
我更看重它把画面输入、键鼠输出、训练和推理优化串成了一条可运行链路。相较于依赖游戏专用 API 的自动化方案,这条路线减少了对内部接口的依赖;代价是状态判断要从画面中完成,稳定性更需要验证。原文没有给出两种路线的对照数据,不能认定它更适合所有测试任务。
开放范围也决定了开发者现在能做什么。团队目前仅公开早期基础预训练研究阶段使用的通用文件,没有公开《崩坏:星穹铁道》相关训练数据,也没有发布使用该游戏数据训练或微调后的模型权重。不能把演示能力等同于拿到文件即可复现。
团队将其定位为学术研究,提出游戏测试、无障碍辅助和人机交互研究等潜在方向,并明确不支持作弊、未经授权访问、利用安全漏洞及损害用户利益或游戏公平性的行为。这些应用方向目前仍应按研究可能性理解。
能拿来做什么
- 如果你负责游戏测试,可以选取获得授权的探索、解谜或流程任务,评估视觉代理能否覆盖部分重复操作,并记录成功率与失败原因。
- 如果你在做交互式 AI 原型,可以借鉴 5 Hz 观察、30 Hz 操作的分离思路,分别测量画面采集、模型推理和指令执行的延迟。
- 如果你准备复现 Gamer,应先核对公开文件的实际内容与硬件要求,再确定实验范围;目前不能预设能直接复现《崩坏:星穹铁道》的演示。